(十二)EndpointSlice
上一章访问 network-nginx Service 时,我们只需要记住一个固定的 ClusterIP,请求就能被转发到后面的 Nginx Pod
但是 Service 自己只保存了入口地址、端口和 selector,它并没有在对象中保存每一个 Pod 的 IP;Pod 被删除重建以后 IP 还会改变,所以 Kubernetes 需要另外一个对象,持续记录 Service 当前可以把请求交给谁
这个对象就是 EndpointSlice
Service 怎样找到 Pod
先创建三个 Nginx Pod,再为他们创建一个 Service
kubectl create deployment endpoint-nginx --image=nginx:latest --replicas=3

# 查看滚动更新状态
kubectl rollout status deployment/endpoint-nginx

# 创建 Service
kubectl expose deployment endpoint-nginx --port=8080 --target-port=80

kubectl get service endpoint-nginx -o wide

kubectl get pods -l app=endpoint-nginx -o wide

kubectl get endpointslices -l kubernetes.io/service-name=endpoint-nginx -o wide
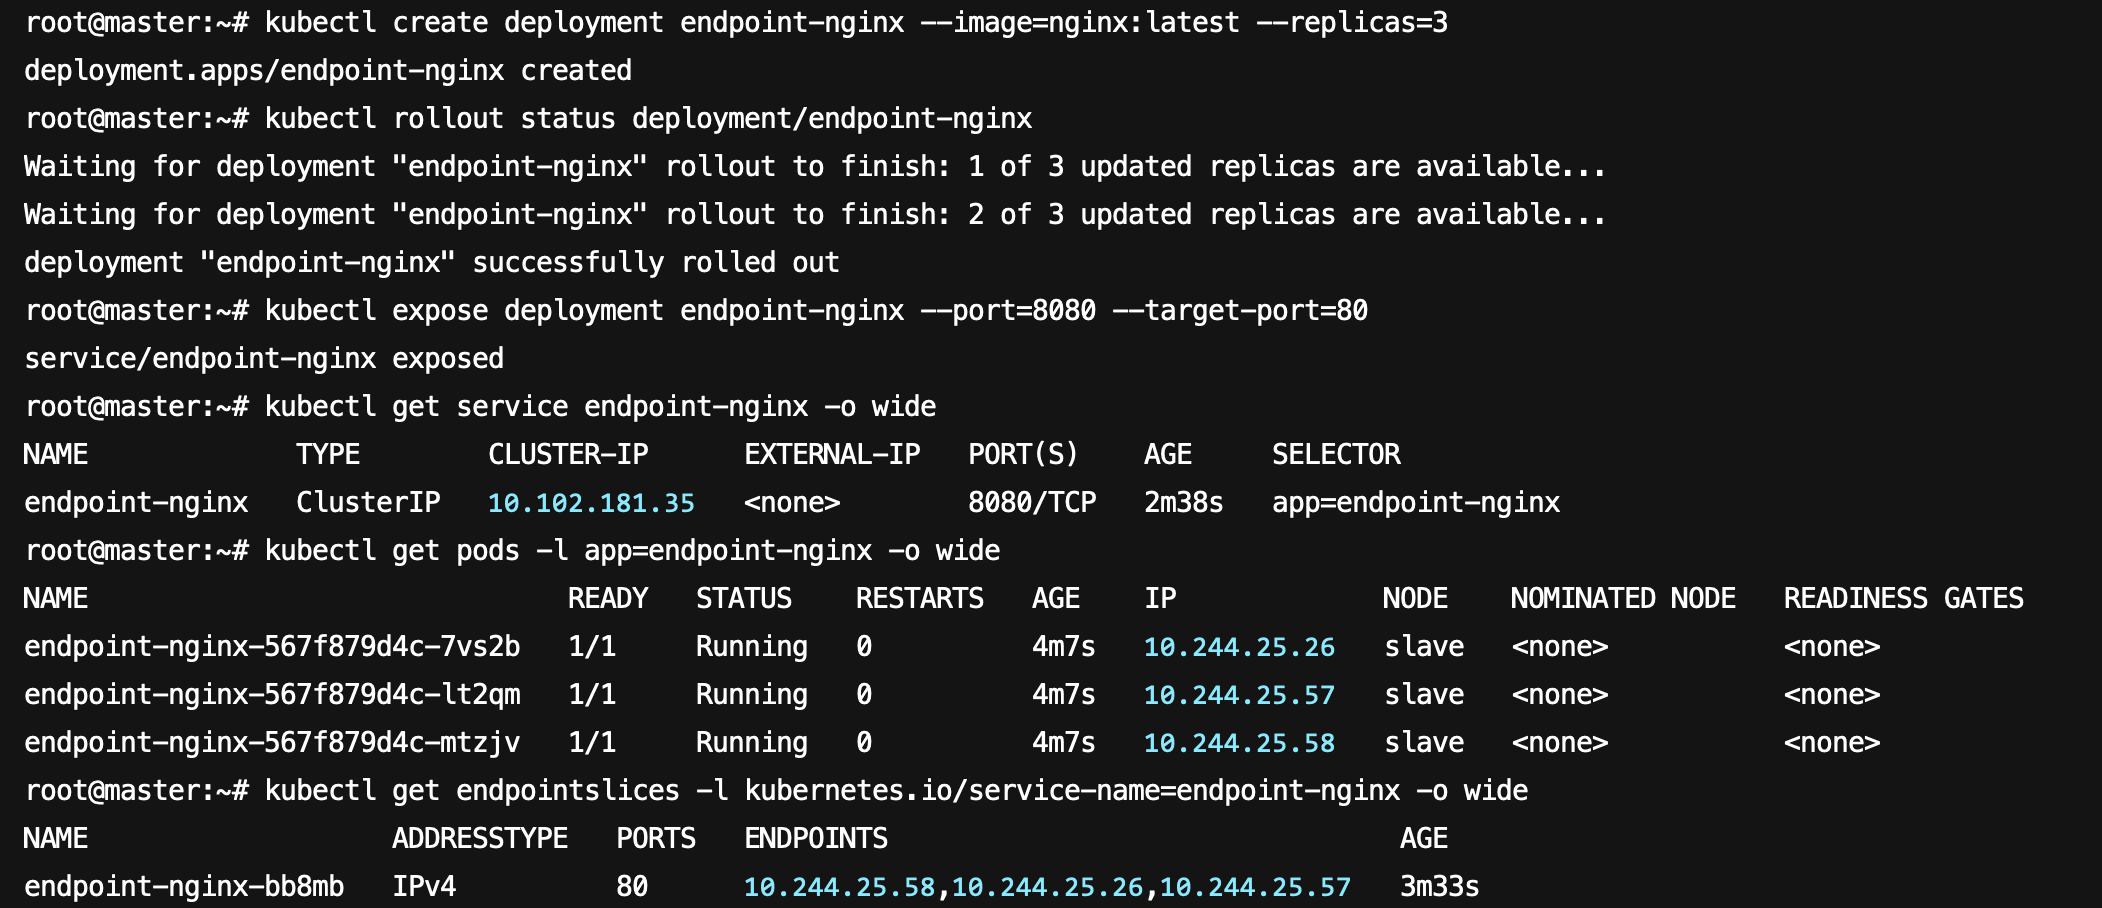
Service 中可以看到固定的 ClusterIP 和 8080 端口,Pod 中可以看到三个会变化的 Pod IP,EndpointSlice 的 ENDPOINTS 列,则是这三个 Pod IP,这三个对象的关系
Service selector
  -> 选择标签符合的 Pod
  -> EndpointSlice 记录可用 Pod 的 IP 和端口
  -> kube-proxy 根据 Service 和 EndpointSlice 维护转发规则
kubectl get endpointslices -l kubernetes.io/service-name=endpoint-nginx -o yaml

# 截取一段来看看
apiVersion: v1
items:
- addressType: IPv4
  apiVersion: discovery.k8s.io/v1
  endpoints:
  - addresses:
    - 10.244.25.58
    conditions:
      ready: true
      serving: true
      terminating: false
    nodeName: slave
    targetRef:
      kind: Pod
      name: endpoint-nginx-567f879d4c-mtzjv
      namespace: default
      uid: f8db0954-7ce0-42a5-a998-7d6e116c32c5
  ports:
  - name: ""
    port: 80
    protocol: TCP
addresses 是后端地址,ports 是后端真正监听的端口,因此客户端访问的是 Service ClusterIP:8080,最终转发到的却是 Pod IP:80
targetRef 说明这个端点来自哪个 Pod,nodeName 说明 Pod 位于哪个节点;ready: true 表示端点已经就绪,可以正常接收 Service 流量
如果 Pod 配置了 readinessProbe,在探针通过以前,它即使已经处于 Running,也不会被当成正常后端;所以就绪探针不只是改变 kubectl get pods 中的 READY,它还会影响 Service 是否把请求交给这个 Pod(探针是 Kubernetes 用来检查容器状态的一种机制)
EndpointSlice 会跟着 Pod 变化
将 Deployment 扩容到 5 个 Pod
kubectl scale deployment endpoint-nginx --replicas=5

kubectl rollout status deployment endpoint-nginx

kubectl get service endpoint-nginx -o wide

kubectl get pods -l app=endpoint-nginx -o wide

kubectl get endpointslices -l kubernetes.io/service-name=endpoint-nginx -o wide
再接着缩容
kubectl scale deployment endpoint-nginx --replicas=2

kubectl rollout status deployment endpoint-nginx

kubectl get service endpoint-nginx -o wide

kubectl get pods -l app=endpoint-nginx -o wide

kubectl get endpointslices -l kubernetes.io/service-name=endpoint-nginx -o wide
可以看到,Pod 增加以后,EndpointSlice 中也会出现新的 Pod IP;再缩容到两个 Pod 后,原本 EndpointSlice 中的 5 个 Pod IP 变成了 2 个 Pod IP,被删除 Pod 的 IP 也会从 EndpointSlice 中消失,并且Service 的 ClusterIP 则始终没有变化
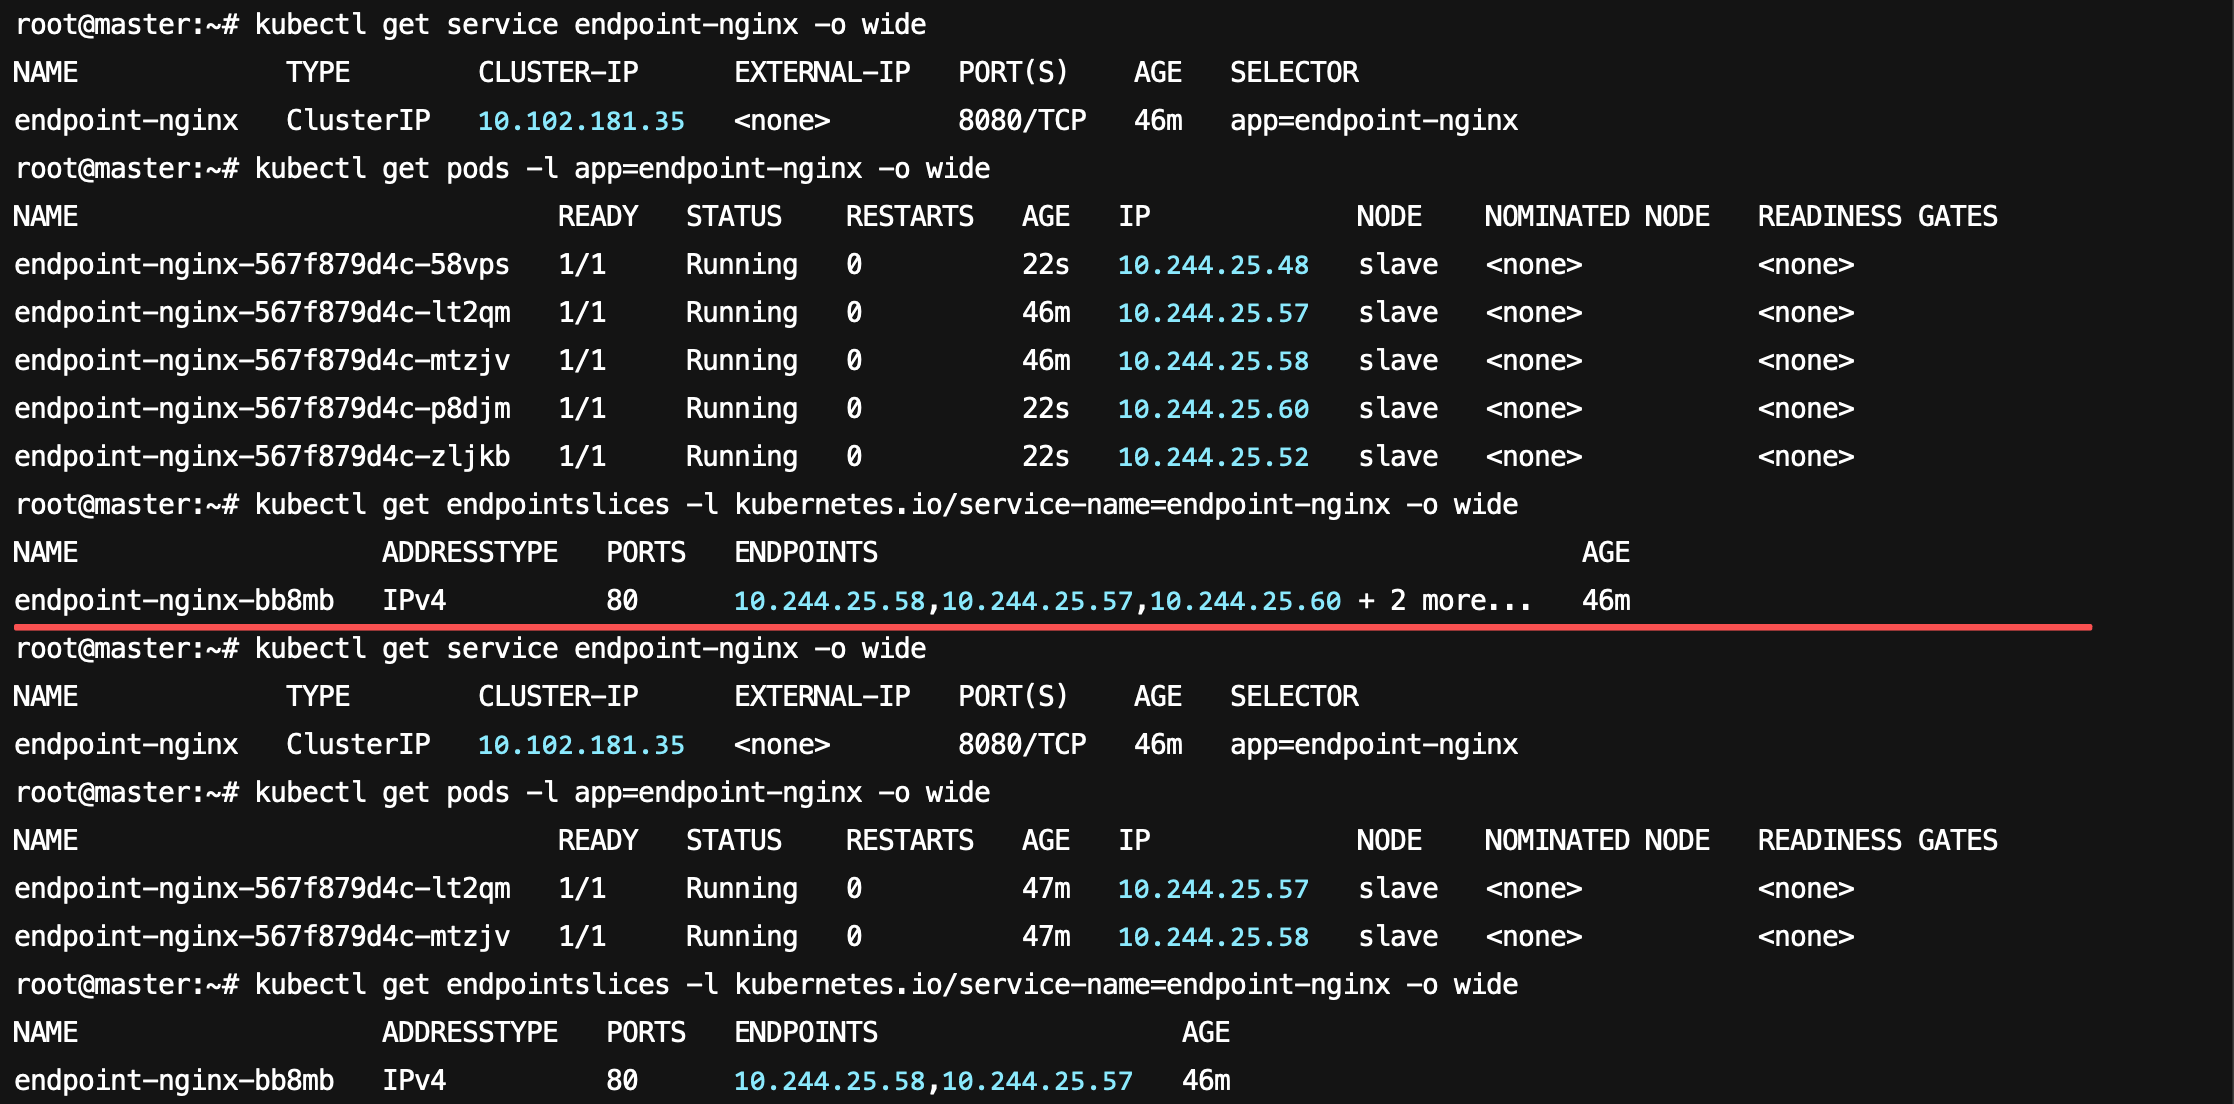
一个 Service 不一定只有一个 EndpointSlice,默认情况下,每个 EndpointSlice 大约保存 100 个端点,后端继续增加时会创建更多 EndpointSlice;所以查看一个 Service 的后端时,不能直接瞎猜
kubectl get endpointslices -l kubernetes.io/service-name={Service名称}
Endpoints 和 EndpointSlice
在旧版本 Kubernetes 中,一个 Service 的所有后端都放在一个 Endpoints 对象里;后端数量变多时,这个大对象每次变化都要整体更新,扩展性比较差,而且超过 1000 个端点时还会被截断
EndpointSlice 从 Kubernetes 1.21 开始稳定使用,它可以把大量后端拆成多个对象,也能更完整地表达双栈地址、就绪状态和拓扑信息等;旧的 Endpoints API 已经从 Kubernetes 1.33 开始弃用
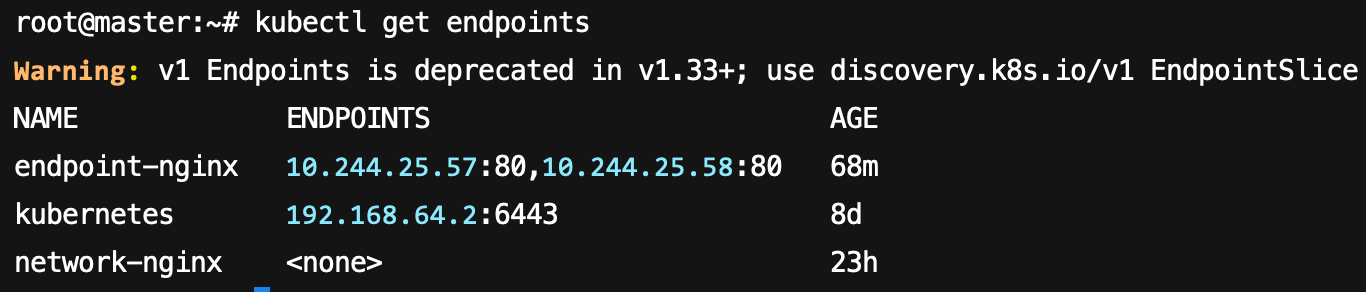
在当前集群中执行旧命令时,会看到警告
kubectl get endpoints
这是因为 Endpoints 目前还没有被删除,主要是为了兼容旧程序;日常使用时,可以先看看使用的 kubectl 的版本,然后再决定使用 EndpointSlice 还是 Endpoints
没有 selector 的 Service
前面的 Service 有 selector,所以 EndpointSlice 由 Kubernetes 自动创建;但 Service 也可以不写 selector
例如,公司有一个数据库还运行在 Kubernetes 外面,集群内应用又不应该到处写死数据库 IP,我们就可以先给它创建一个 Service,再手工告诉 Service 后端地址是什么;以后数据库迁移时,应用仍然访问原来的 Service 名称
这里先用一个没有被 Service selector 管理的 Pod 模拟外部服务
# 创建一个Pod,并运行 nginx 镜像
kubectl run external-nginx --image=nginx:1.20.0 --restart=Never

# 超时等待 Pod 进入 Ready
kubectl wait pod external-nginx --for=condition=Ready --timeout=120s

kubectl get pod external-nginx -o wide

# 创建一个没有 selector 的 Service
cat > manual-service.yaml <<'EOF'
apiVersion: v1
kind: Service
metadata:
  name: manual-web
spec:
  ports:
  - name: http
    protocol: TCP
    port: 8081
    targetPort: 80
EOF

kubectl apply -f manual-service.yaml

kubectl get service manual-web

kubectl get endpointslices -l kubernetes.io/service-name=manual-web
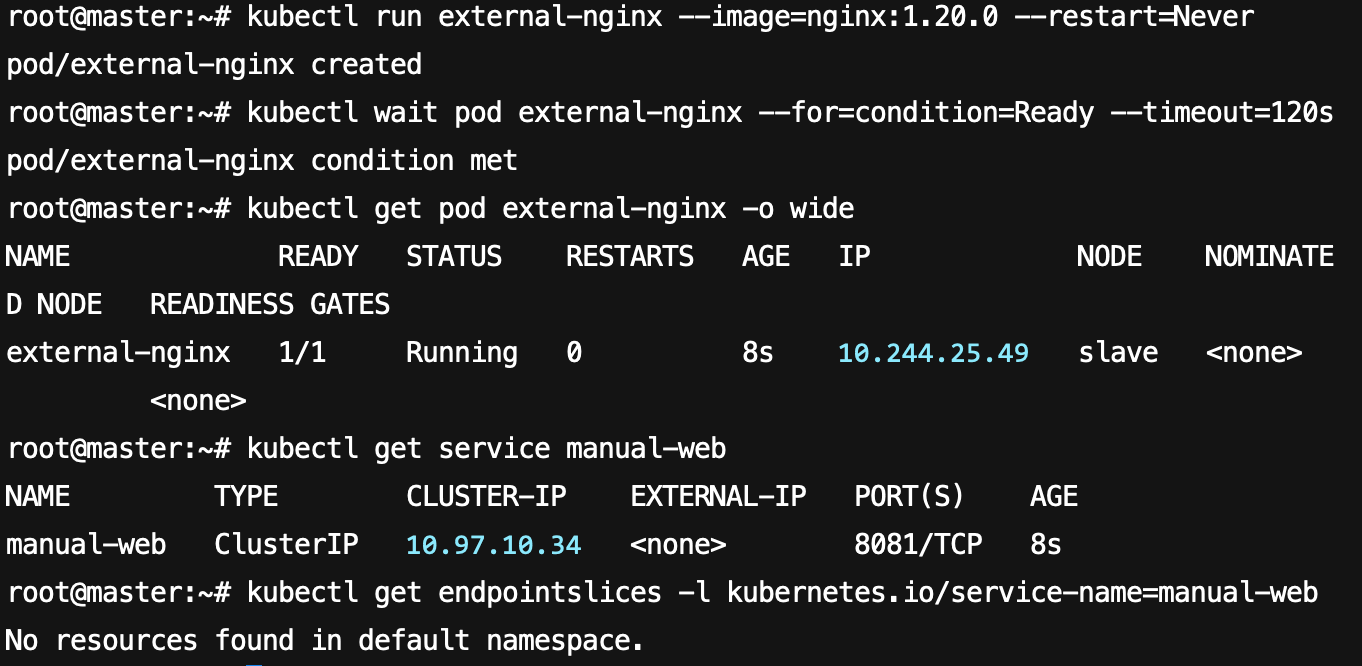
可以看到,Service 已经获得 ClusterIP,但是最后一条命令查不到 EndpointSlice,这因为它没有 selector,Kubernetes 不知道应该选择哪些 Pod,也不会自动生成后端列表
# BACKEND_IP="$(kubectl get pod external-nginx -o jsonpath='{.status.podIP}')"
kubectl get pod external-nginx -o yaml | grep podIP

# 在 endpoints 中的 address 填写 查到的 podIP
cat > manual-endpointslice.yaml <<EOF
apiVersion: discovery.k8s.io/v1
kind: EndpointSlice
metadata:
  name: manual-web-1
  labels:
    kubernetes.io/service-name: manual-web
    endpointslice.kubernetes.io/managed-by: cluster-admins
addressType: IPv4
ports:
- name: http
  protocol: TCP
  port: 80
endpoints:
- addresses:
  - {podIP}
  conditions:
    ready: true
EOF

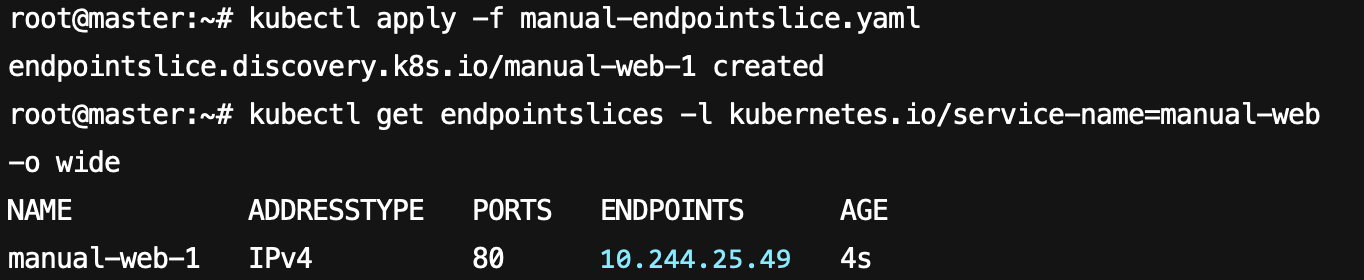
kubectl apply -f manual-endpointslice.yaml

kubectl get endpointslices -l kubernetes.io/service-name=manual-web -o wide
kubernetes.io/service-name: manual-web
ports.port 填的是后端 Nginx 监听的 80,Service 的 port 则是客户端访问的 8081;两边的端口名称都叫 http,因此能够对应起来
现在通过 Service 访问这个没有 selector 的后端
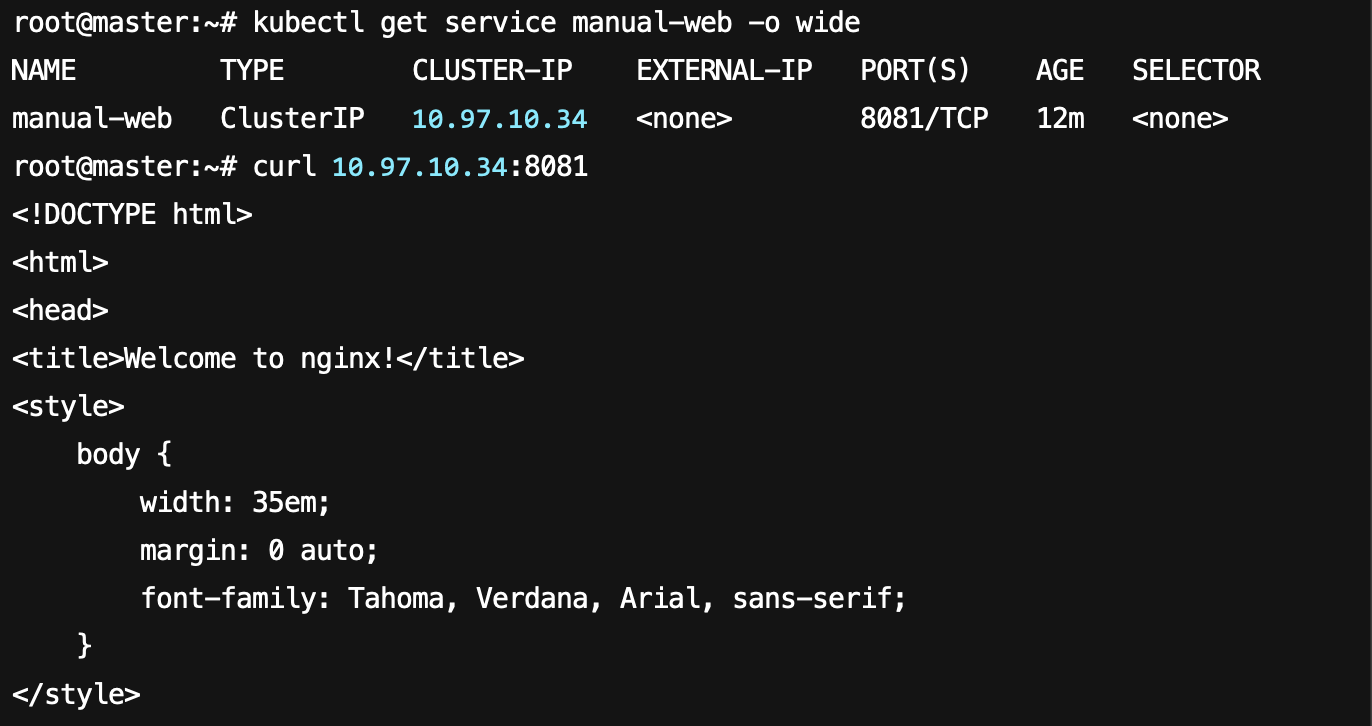
kubectl get service manual-web -o wide

curl {CLUSTER-IP}:8081
可以看到,访问成功了,而 请求 的路径则是
manual-web ClusterIP:8081
  -> manual-web-1 EndpointSlice
  -> external-nginx IP:80
实验中虽然使用 Pod IP 方便验证,但这种方式的价值,是 EndpointSlice 中可 以填写由管理员维护的集群外服务器地址,Service 和 后端 因此不必绑死在一块
代价也很明显:手工创建的 EndpointSlice 不会自动跟踪后端变化,如果外部服务器换了 IP,必须 人为 或者有 专门的控制器 更新它,以及端点也不能填写环回地址、链路本地地址,或者另一个 Service 的 ClusterIP
PS
"后端xx" 概念
本文提及了很多 "后端xx" 这个概念,这个并非传统上的 服务器,而是一个抽象的描述
- 请求经过当前这一层以后,下一步要交给谁,谁就是这一层的后端
以 Service 为例
客户端
-> Service 10.102.181.35:8080
-> Pod 10.244.25.58:80
客户端首先访问 Service,所以 Service 是入口,Service 最终把请求交给 Pod,因此对 Service 来说,Pod 就是它的后端,10.244.1.10:80就是 "后端地址" ## 转发规则 转发规则,可以理解为节点操作系统中的一组判断,如果有人访问某个 Service 的 IP 和端口,就从 EndpointSlice 记录的 Pod 中选择一个,并把请求的目标地址改成这个 Pod 的 IP 和端口;这样,我们就能理解 kube-proxy 维护的转发规则是什么意思了
kube-proxy 根据 Service 的入口地址和 EndpointSlice 中的 Pod 地址,告诉 Linux:访问这个 Service 的请求应该改送到哪些 Pod
这就是转发规则,只是字面上理解起来,并不是那么直观
总结
这一章的内容其实并不算多,更重要的是一种理解吧,理解 EndpointSlice 是什么
EndpointSlice 就是 Service 后面的地址簿,Service 提供稳定入口,EndpointSlice 记录当前真正可以接收请求的后端,kube-proxy 根据两者维护转发规则
有 selector 时,这份地址簿由 Kubernetes 根据 Pod 自动维护;没有 selector 时,也可以手工提供后端地址,把 Kubernetes 内的 Service 名称和集群外服务连接起来
愿诸君顺遂