(十)Jobs、CronJobs
在 Kubernetes 中,常用的工作负载/控制器,有 Deployment、ReplicaSet、StatefulSet、DaemonSet、Job、Cronjob、ReplicationController 等,本章将学习 Job 和 Cronjob
我们知道,Pod 是一种临时性的对象,单独创建 Pod,一般用于临时测试调试,在生产中我们使用 Deployment 等对 Pod 进行管理,而 Job、Cronjob 它们主要用于创建一个或多个 Pod,来完成某些任务,它们创建的 Pod 不会长久的运行在节点中
Job
Job 是用来只运行一次任务的对象,Job 对象以一种可靠的方式运行某 Pod 直到完成,适合用于批处理,例如编译程序、执行运算任务,Job 适合一次到位或者一次完整的流程,完成后即可抛弃的任务
控制器的异同点
这里主要对比 Pod、Deployment / ReplicaSet 和 Job 的区别,主要对比的是这个字段
apiVersion: v1
kind: Pod

apiVersion: apps/v1
kind: Deployment

apiVersion: apps/v1
kind: ReplicaSet

apiVersion: batch/v1
kind: Job
Pod 是什么
Pod 是 Kubernetes 中运行容器的基本单位;Pod 被创建后,会获得一个唯一的 ID,并被调度到某个 Node 上运行;Pod 本身是一个临时资源,并不能保证一直存在,当出现
- Pod 所在的 Node 发生故障
- Pod 被删除
- Node 进入维护状态
- 集群重新调度资源
这些情况都可能导致原来的 Pod 消失,因此,一般不会依赖单独的 Pod 来长期维持一个应用
Pod 的 restartPolicy
Pod 可以通过 restartPolicy 控制容器退出后的处理方式,restartPolicy 管理的是 Pod 内部的容器,而不是重新创建整个 Pod
- restartPolicy: Always
- restartPolicy: OnFailure
- restartPolicy: Never
三种策略分别表示:
- Always:容器退出后重新启动
- OnFailure:容器异常退出时重新启动
- Never:容器退出后不重新启动
可以理解为:
Pod
└── Container
      ↓
   Container 退出
      ↓
restartPolicy 决定是否重新启动 Container
如果整个 Pod 已经不存在了,Pod 不会自己重新创建自己
为什么需要控制器
控制器的作用,就是持续观察当前状态,并尽量让实际状态符合预期状态,比如 副本数
- 期望有 3 个 Pod ——> 当前只有 2 个 Pod ——> 控制器再创建 1 个 Pod Deployment、ReplicaSet、Job 都可以管理 Pod,但它们管理 Pod 的目标不同 ### Deployment / ReplicaSet Deployment / ReplicaSet 管理的是需要长期运行的 Pod,比如 Nginx、Web 服务、后端 API 服务...
这些应用希望 Pod 一直保持运行,当 replicas=3 时,其中一个 Pod 消失,ReplicaSet 就会发现 少了一个,然后重新创建一个新的 Pod
所以 Deployment / ReplicaSet 的目的是 保证指定数量的 Pod 持续运行,而 Deployment 又在 ReplicaSet 的基础上增加了滚动更新、回滚等能力
Job
Job 管理的是执行完成后应该结束的任,比如 数据库备份、数据迁移、批处理、一次性计算任务;Job 创建的 Pod 能使用的 restartPolicy 只有 OnFailure 与 Never
- 使用 OnFailure 会控制 Pod 内部的 Container 是否重新启动
- 使用 Never ,可以设置 backoffLimit 约束 Pod,代表 Job 任务失败后允许重试多少次
当 Job 创建 Pod 执行任务时,Job ——> Pod ——> ...——> Pod 结束 ——> Job 完成,这里的 Pod 退出并不是异常现象,而是 Job 的期望,执行完成就退出
所以 Job 和 Deployment / ReplicaSet 的区别就是 对 Pod 的期望是怎么样的,是希望一直运行,还是可以退出
Job
当 Job 启动时,Job 会跟踪成功完成的 Pod 的个数,当成功数量达到某个阈值时,Job 会被终结;当 Job 运行过程中,我们 暂停 / 挂起 Job,Job 会删除正在运行的 Pod,保留已完成的 Pod 数量,当恢复 Job 时,会创建新的 Pod,继续完成任务
非并行 Job
这类 Job 的特点是,一次只启动一个 Pod ,除非 Pod 启动失败;当 Pod 成功终止时,Job 被立即视为完成状态
cat > job.yaml <<'EOF'
apiVersion: batch/v1
kind: Job
metadata:
  name: busybox
spec:
  template:
    spec:
      containers:
      - name: busybox
        image: busybox
        command: ["/bin/sleep"]
        args: ["3"]
      restartPolicy: Never
EOF

# 直接复制执行
kubectl apply -f job.yaml
kubectl get jobs
kubectl get pods

# 等 3 s
kubectl get jobs

kubectl get pods
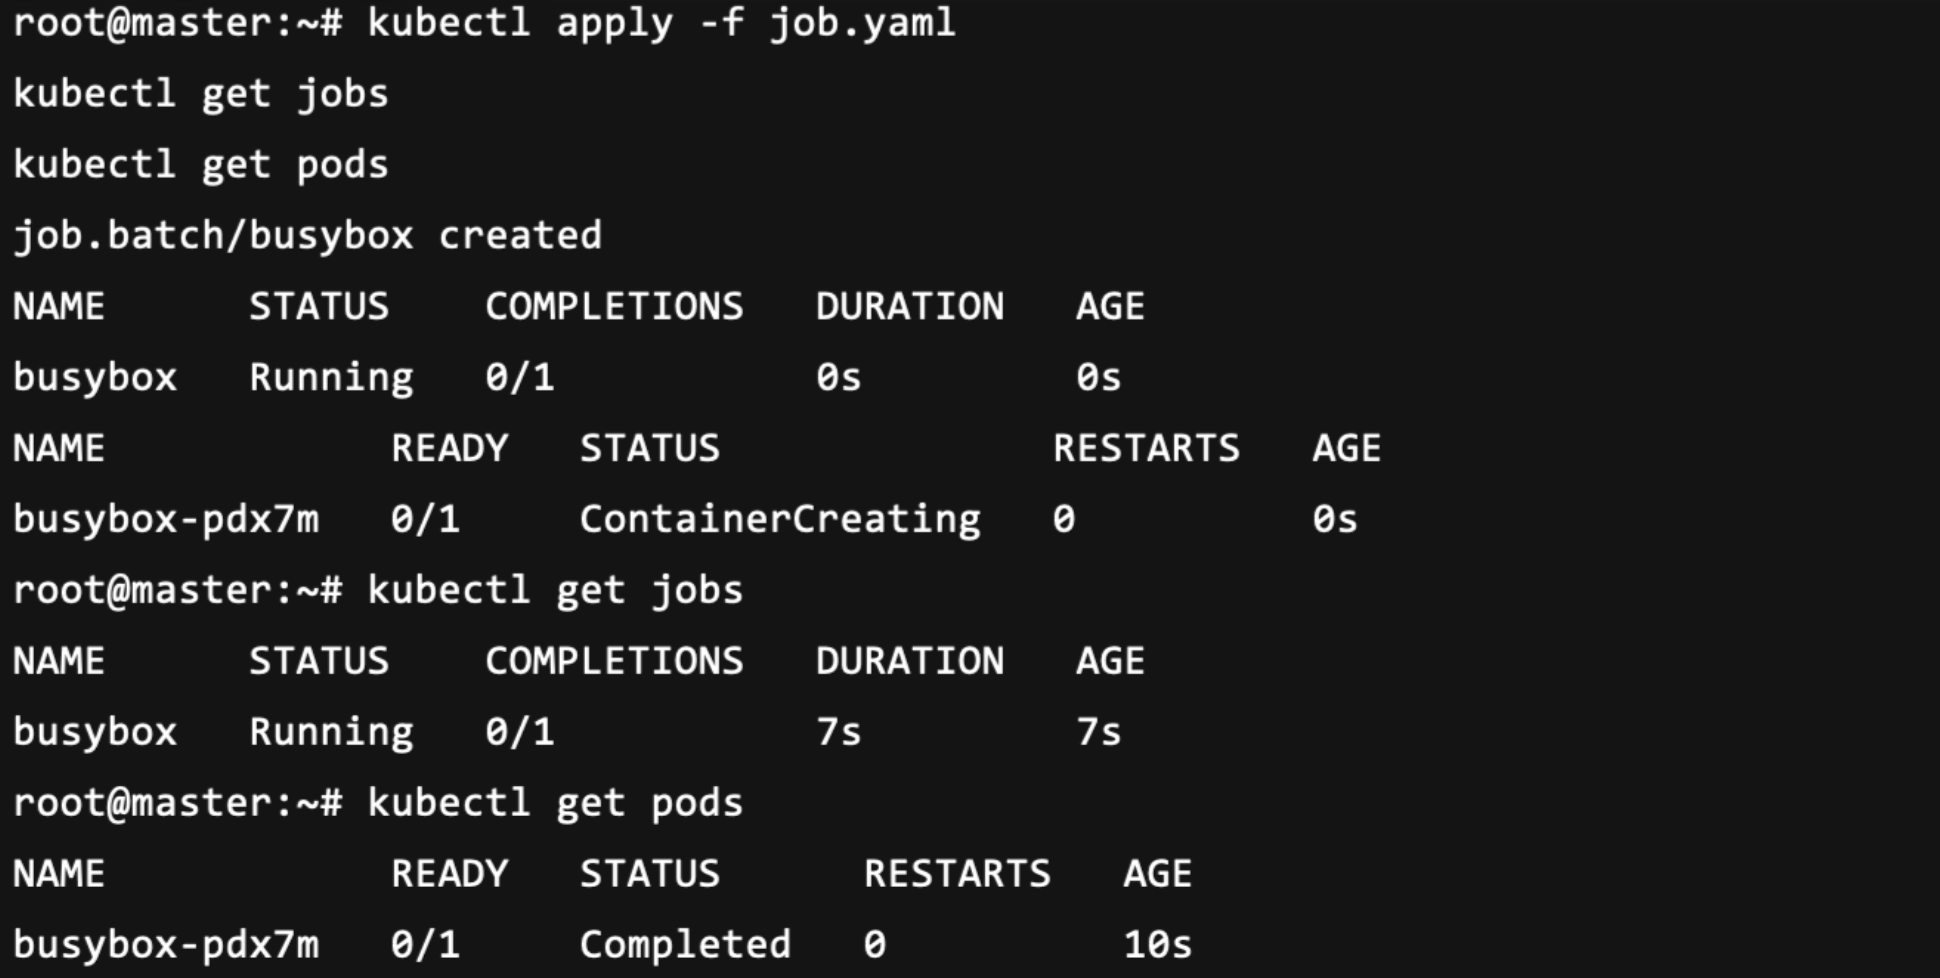
可以看到,Pod 被标记为 Completed
完成数
使用 .spec.completions 来设置完成数时,Job 控制器所创建的每个 Pod 使用完全相同的 spec 模板,这意味着任务的所有 Pod 都有相同的命令行,都使用相同的镜像和数据卷,甚至连 环境变量都几乎相同
cat > job.yaml <<'EOF'
apiVersion: batch/v1
kind: Job
metadata:
  name: busybox
spec:
  completions: 5
  template:
    spec:
      containers:
      - name: busybox
        image: busybox
        command: ["/bin/sleep"]
        args: ["3"]
      restartPolicy: Never
EOF

kubectl apply -f job.yaml
kubectl get jobs
kubectl get pods

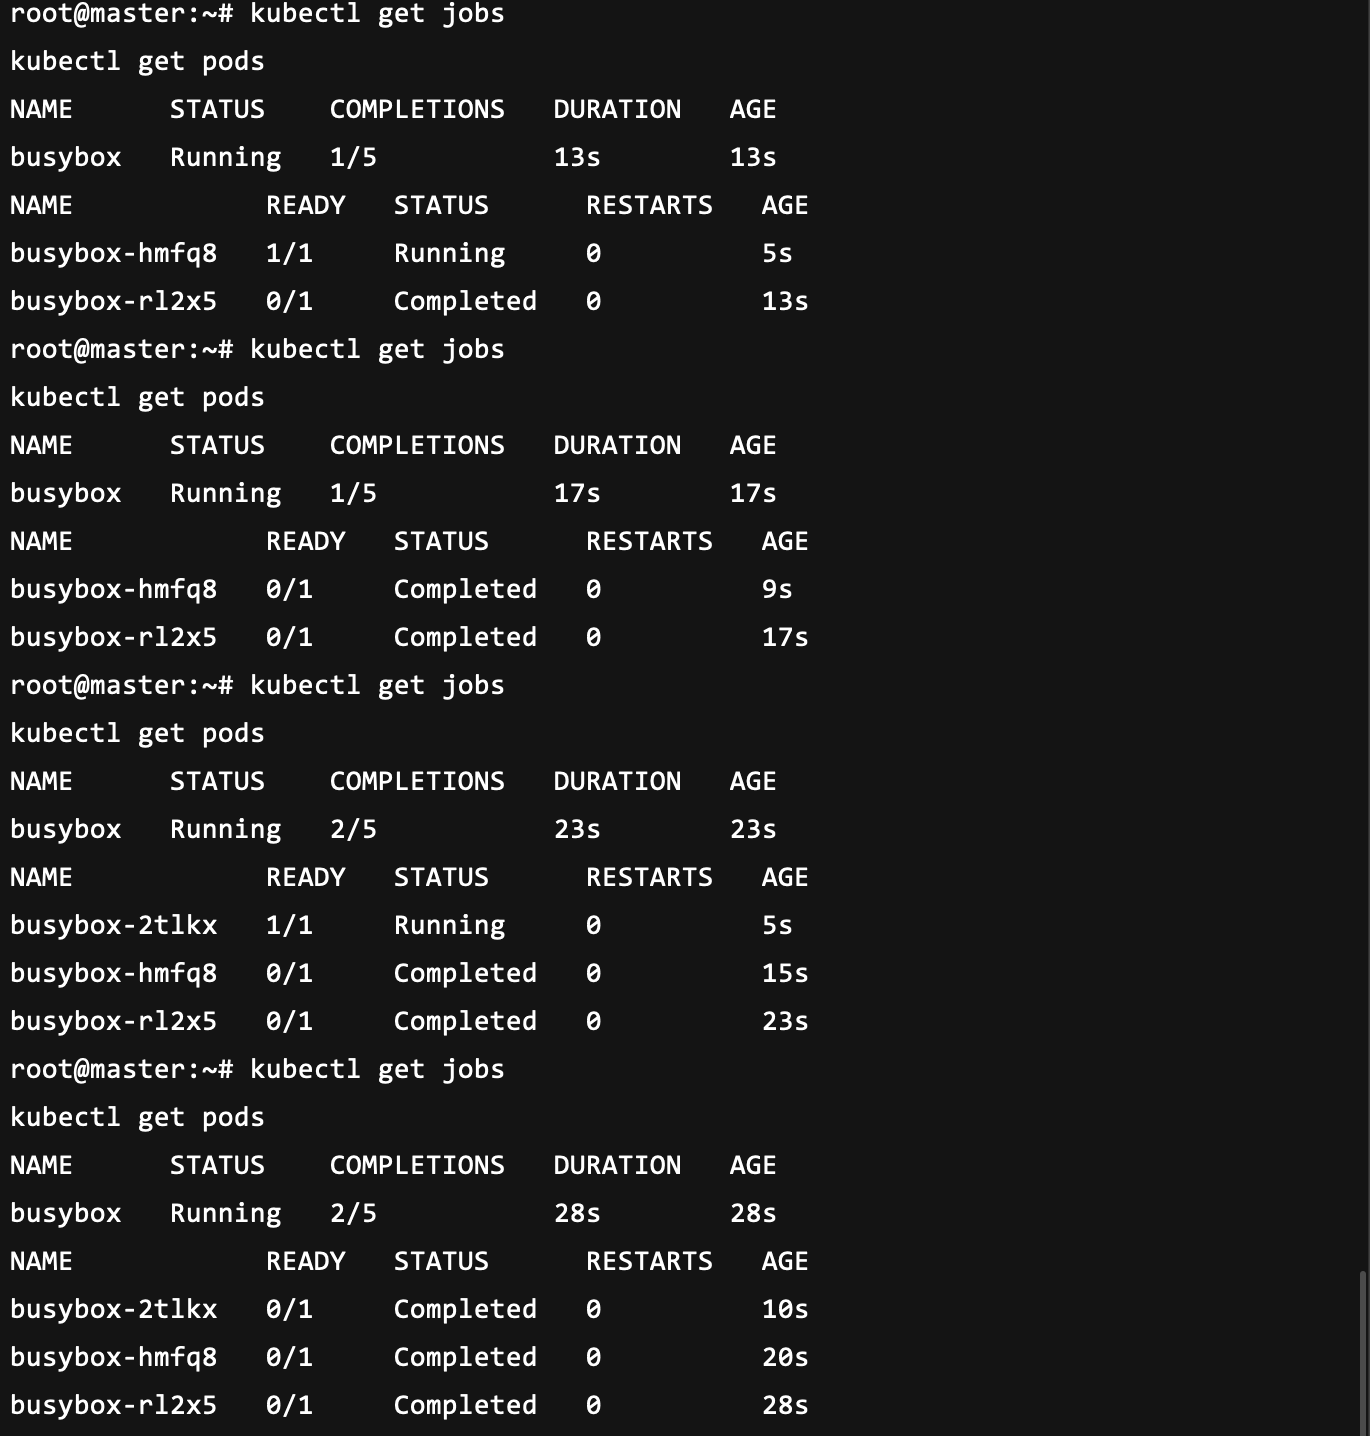
可以多执行几次
kubectl get jobs
kubectl get pods
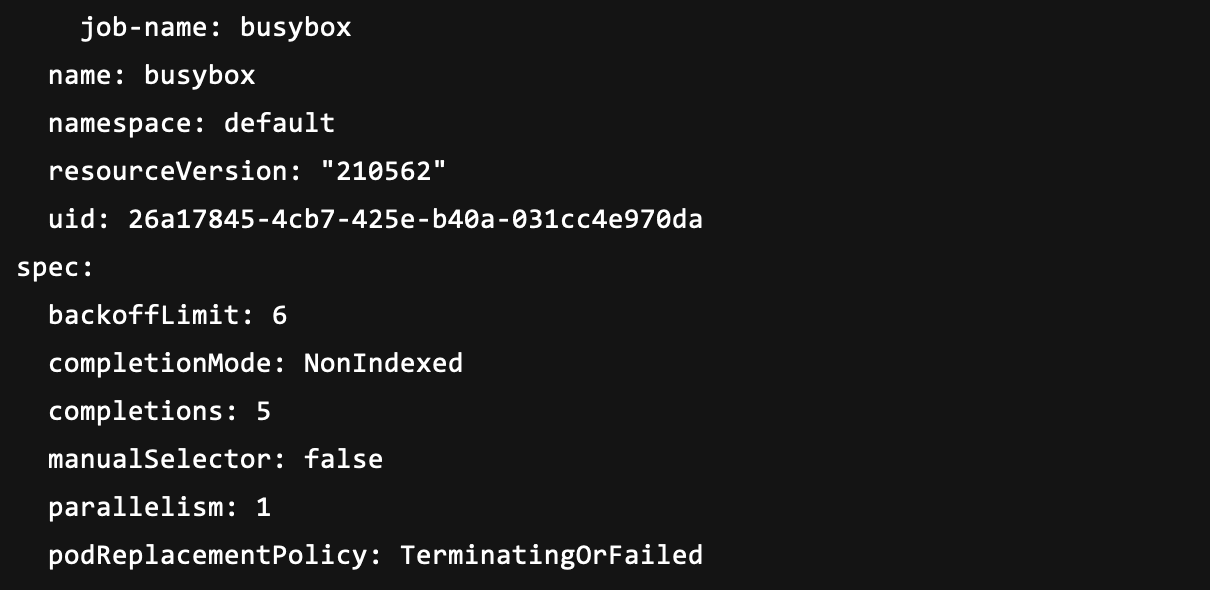
由于没有显式设置并行度,Pod 会逐个执行,Job 的 COMPLETIONS 会从 0/5 逐渐达到 5/5,最终保留五个 Completed Pod;.spec.completions: 5 表示需要五次成功完成,Job 创建的各个 Pod 使用同一个 Pod 模板,因此镜像、命令和其他模板配置相同
kubectl get job busybox -o yaml

kubectl delete job busybox
并行 Job
通过设置 parallelism 字段,可以控制 Pod 执行任务时的并行数量
cat > parallel-job.yaml <<'EOF'
apiVersion: batch/v1
kind: Job
metadata:
  name: busybox-parallel
spec:
  completions: 5
  parallelism: 2
  template:
    spec:
      containers:
      - name: busybox
        image: busybox
        command: ["/bin/sleep"]
        args: ["3"]
      restartPolicy: Never
EOF

kubectl apply -f parallel-job.yaml
kubectl get jobs
kubectl get pods
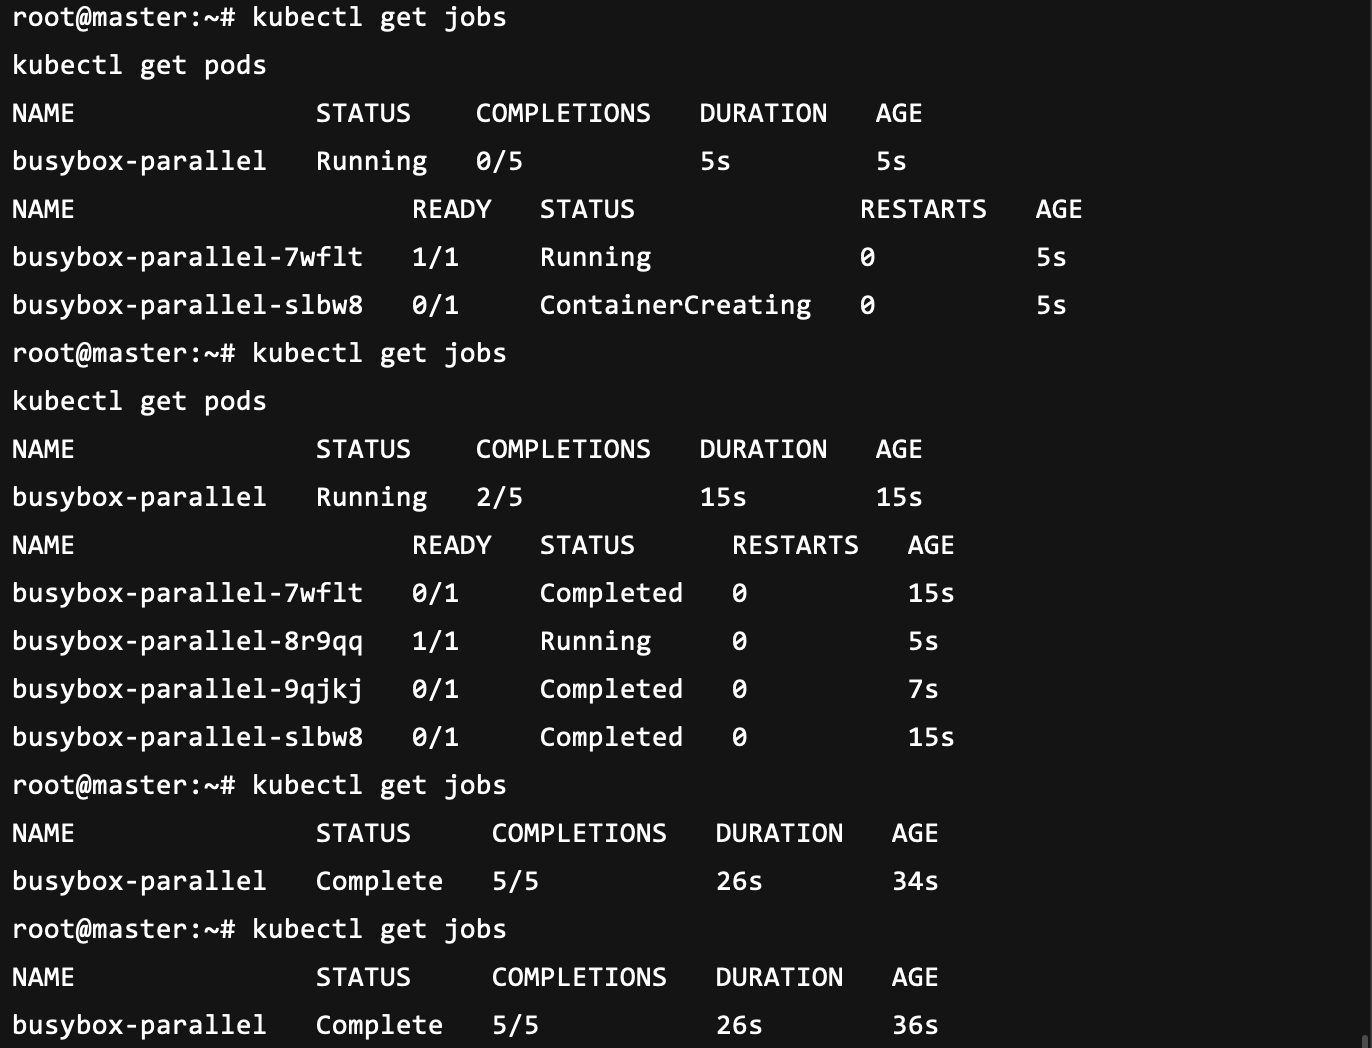
可以看到,允许同时运行最多两个 Pod,直到累计五个 Pod 成功完成
.spec.parallelism 可以设置为任何非负整数,如果设置为 0,则 Job 相当于启动之后便被暂停,因为一直没有 Pod 完成,当然我们可以使用 kubectl edit 命令修改其值
另外,Job 运行时,可以使用 kubecl scale job xxxx --replicas=n 修改 Job 的并行数量 parallelism 字段的值
带工作队列的 Job
带工作队列的 Job,指设置了 .spec.parallelism,可以不设置 .spec.completions 的 Job,此时 Job 需要等待所有的 Pod 完成任务,Job 才能终结
当然,这类任务通常依赖 RabbitMQ 等外部服务分配工作:
- 多个 Pod 相互协调,或通过外部服务领取任务
- 任意 Pod 成功结束后,Job 不再创建新 Pod
- 已经运行的其他 Pod 继续结束
- 至少一个 Pod 成功且全部 Pod 都终止后,Job 才标记完成
以 RabbitMQ 为例,Job 可以同时启动 5 个 Pod 消费队列中的消息,每个 Pod 不断从 RabbitMQ 获取并处理任务,当某个 Pod 发现队列中已经没有新的任务了,并确认自己的工作已经完成后,就可以正常退出了;此时 Job 不一定立即完成,因为其他 Pod 可能还在处理已经取出的消息,当这些 Pod 都完成当前任务并正常退出后,Job 才算最终完成
带类型的 Job
Job 中的 Pod 都是一样的,因此如果要 Job 处理不同的工作任务,则需要外界帮忙
比如一个电商平台,消息队列中有评论、问答、差评、订单、退货 五类消息;虽然 Job 创建的 Pod 使用相同的 Pod 模板,但每个 Pod 可以从消息队列中领取不同的任务,同一个 worker 程序可以根据任务类型执行不同的处理逻辑,因此多个相同的 Pod 可以并行处理不同类型的任务
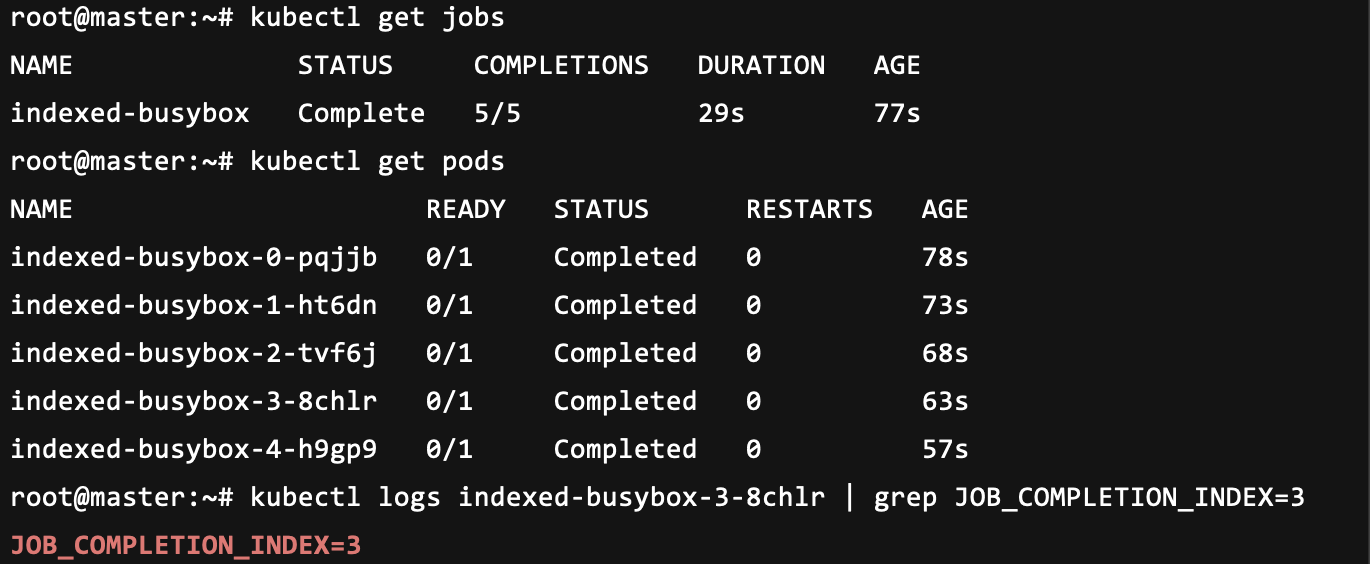
在 Job 创建的 Pod 中,会有个名为 JOBCOMPLETIONINDEX 的环境变量,此环境变量标识了 Pod 的索引,Pod 可以通过此索引标识自己的身份
cat > indexed-job.yaml <<'EOF'
apiVersion: batch/v1
kind: Job
metadata:
  name: indexed-busybox
spec:
  parallelism: 1
  completions: 5
  completionMode: Indexed
  template:
    spec:
      containers:
      - name: busybox
        image: busybox
        command: ["env"]
      restartPolicy: Never
EOF

kubectl apply -f indexed-job.yaml
kubectl get jobs
kubectl get pods

# pod 会出现 0 -> 4 的完成索引,取其一进行日志查看
kubectl logs indexed-busybox-3-8chlr
可以看到 completionMode: Indexed 表明当前 Pod 是带索引的,如果 completionMode: NonIndexed 则是不带索引
处理 Pod 和容器失效
Job 终止和清理
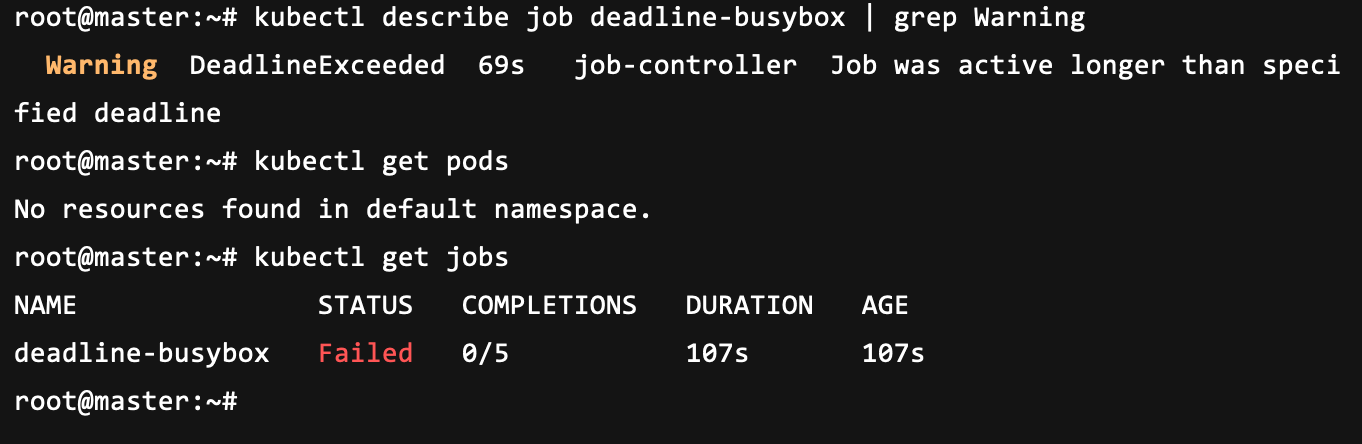
如果我们不希望 Job 运行太长时间,可以为 Job 的 .spec.activeDeadlineSeconds 设置一个 秒级 数值,在 Job 的整个生命期,无论 Job 创建了多少个 Pod, 一旦 Job 运行时间达到 activeDeadlineSeconds 秒,其所有运行中的 Pod 都会被终止,并且 Job 的状态更新为 type: Failed 及 reason: DeadlineExceeded
cat > job-deadline.yaml << 'EOF'
apiVersion: batch/v1
kind: Job
metadata:
  name: deadline-busybox
spec:
  completions: 5
  activeDeadlineSeconds: 2
  template:
    spec:
      containers:
      - name: busybox
        image: busybox
        command: ["/bin/sleep"]
        args: ["3"]
      restartPolicy: Never
EOF

kubectl apply -f job-deadline.yaml

kubectl get jobs

kubectl describe job deadline-busybox ( | grep Warning )

kubectl delete job deadline-busybox
CronJob
CronJobs 对于创建周期性的、反复重复的任务很有用,例如执行数据备份或者发送邮件, CronJobs 也可以用来计划在指定时间时来执行的独立任务,例如计划当集群看起来很空闲时 执行某个 Job
CronJob 有 个 schedule 字段,用来配置合适启动此 CronJob,其使用五个时间单位,每一位表示一个时刻
# ┌───────────── 分钟(0-59)
# │ ┌───────────── 小时(0-23)
# │ │ ┌───────────── 月中的日期(1-31)
# │ │ │ ┌───────────── 月份(1-12)
# │ │ │ │ ┌───────────── 星期(0-6,0 表示星期日)
# │ │ │ │ │
# * * * * *
常见表达式:
| 表达式 | 含义 | 简写 |
|---|---|---|
0 * * * * | 每小时的第 0 分钟 | @hourly |
0 0 * * * | 每天 0:00 | @daily |
0 0 * * 0 | 每周日 0:00 | @weekly |
0 0 1 * * | 每月 1 日 0:00 | @monthly |
0 0 1 1 * | 每年 1 月 1 日 0:00 | @yearly |
四种常用符号:
| 符号 | 含义 | 示例 |
|---|---|---|
* | 该位置的所有有效值 | * * * * * 每分钟 |
, | 列出多个值 | 1,5,6 * * * * 每小时的第 1、5、6 分钟 |
- | 连续范围 | 0-2 * * * * 每小时的第 0、1、2 分钟 |
/ | 按指定步长 | */5 * * * * 每五分钟 |
组合示例:
23 0-20/2 * * *
表示每天在 0:23、2:23、4:23,依次每隔两小时执行,直到 20:23
非常头大对吧,确实头大
# 此 CronJob 会每分钟执行一次
cat > cron-job.yaml << 'EOF'
apiVersion: batch/v1
kind: CronJob
metadata:
  name: hello
spec:
  schedule: "*/1 * * * *"
  jobTemplate:
    spec:
      template:
        spec:
          containers:
          - name: hello
            image: busybox
            imagePullPolicy: IfNotPresent
            command:
            - /bin/sh
            - -c
            - date; echo Hello from the Kubernetes cluster
          restartPolicy: OnFailure
EOF

kubectl apply -f cron-job.yaml

kubectl get cronjobs

# 等待一分钟后
kubectl get cronjobs
kubectl get jobs
kubectl get pods

# 取得 `hello-` 开头的实际 Pod 名称 查看日志
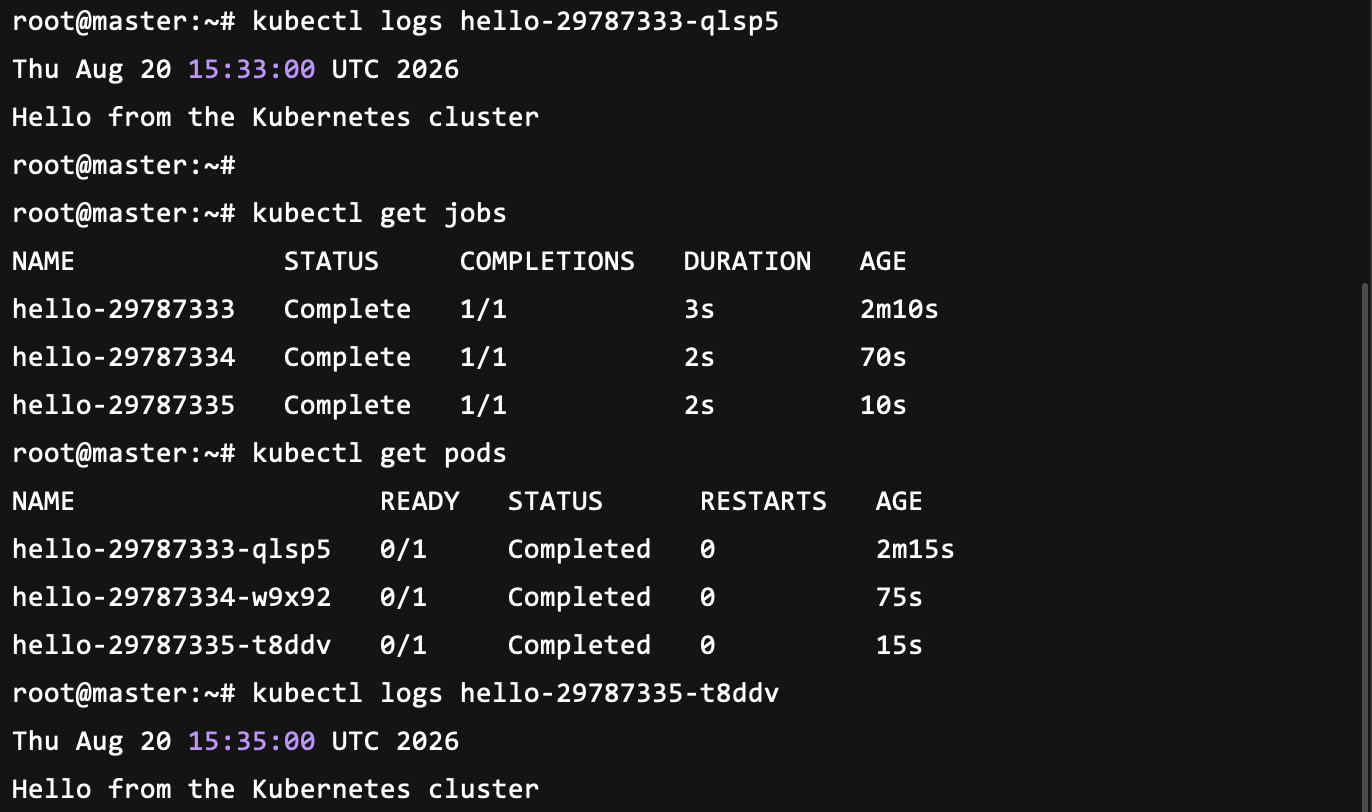
kubectk logs hello-29787333-qlsp5

# 等待一分钟后
kubectl get jobs
kubectl get pods
kubectl logs hello-29787335-t8ddv
可以看到,此 CronJob 会每分钟执行一次,执行了 3 次,产生了 3 个 Job 和 3 个 Pod
总结
今天说难也不难,简单也不简单,主要是内容很多,不容易记住
但是最精华的地方其实就是,理解 Deployment、ReplicaSet、Job 三个的区别,以及 Job 可以并行、非并行执行,可以通过 xx 字段控制失败重启、以及可以对接消息队列、可以通过类型去执行不同的工作
愿诸君顺遂