(十一)Kubernetes 网络模型
前面学习 ReplicaSet 时,我们提到过 Service,它可以把多个 Pod 关联起来,学到 Pod 端口时,也用 Service 把 9999 端口转发到了 Nginx 的 80 端口(具体可看 第五章 Pod 端口映射)
不过那时只是先用一下,并没有认真解释 Service 是怎么找到 Pod 的、Pod 的 IP 是怎么来的,以及为什么在 master 上能够访问运行在 slave 上的 Pod
本章就用来讲解一下这些东西是怎么关联的
Kubernetes 网络模型
Kubernetes 网络主要处理下面这些通信
- 同一个 Pod 中,容器与容器之间的通信
- Pod 与 Pod 之间的通信
- Pod 与 Service 之间的通信
- 集群外部与 Service 之间的通信
同一个 Pod 中的容器共享一套网络环境,它们有相同的 Pod IP,也可以通过 localhost 互相访问,正因为在同一个网络,一个 Pod 内的两个容器不能同时监听相同端口,这和一台主机上的两个程序抢占同一个端口是一样的
不同 Pod 则会获得不同 IP,哪怕它们在不同 Node 上,也应该能够直接通信
这里说的 "应该",是因为 Kubernetes 只规定了网络模型,并没有亲自去实现,真正负责 Pod IP、路由和跨节点通信的是 CNI 网络插件,而我们在第一章进行集群通信时,安装的就是 Calico
kubectl get pods -n kube-system -o wide

kubectl get daemonsets -n kube-system
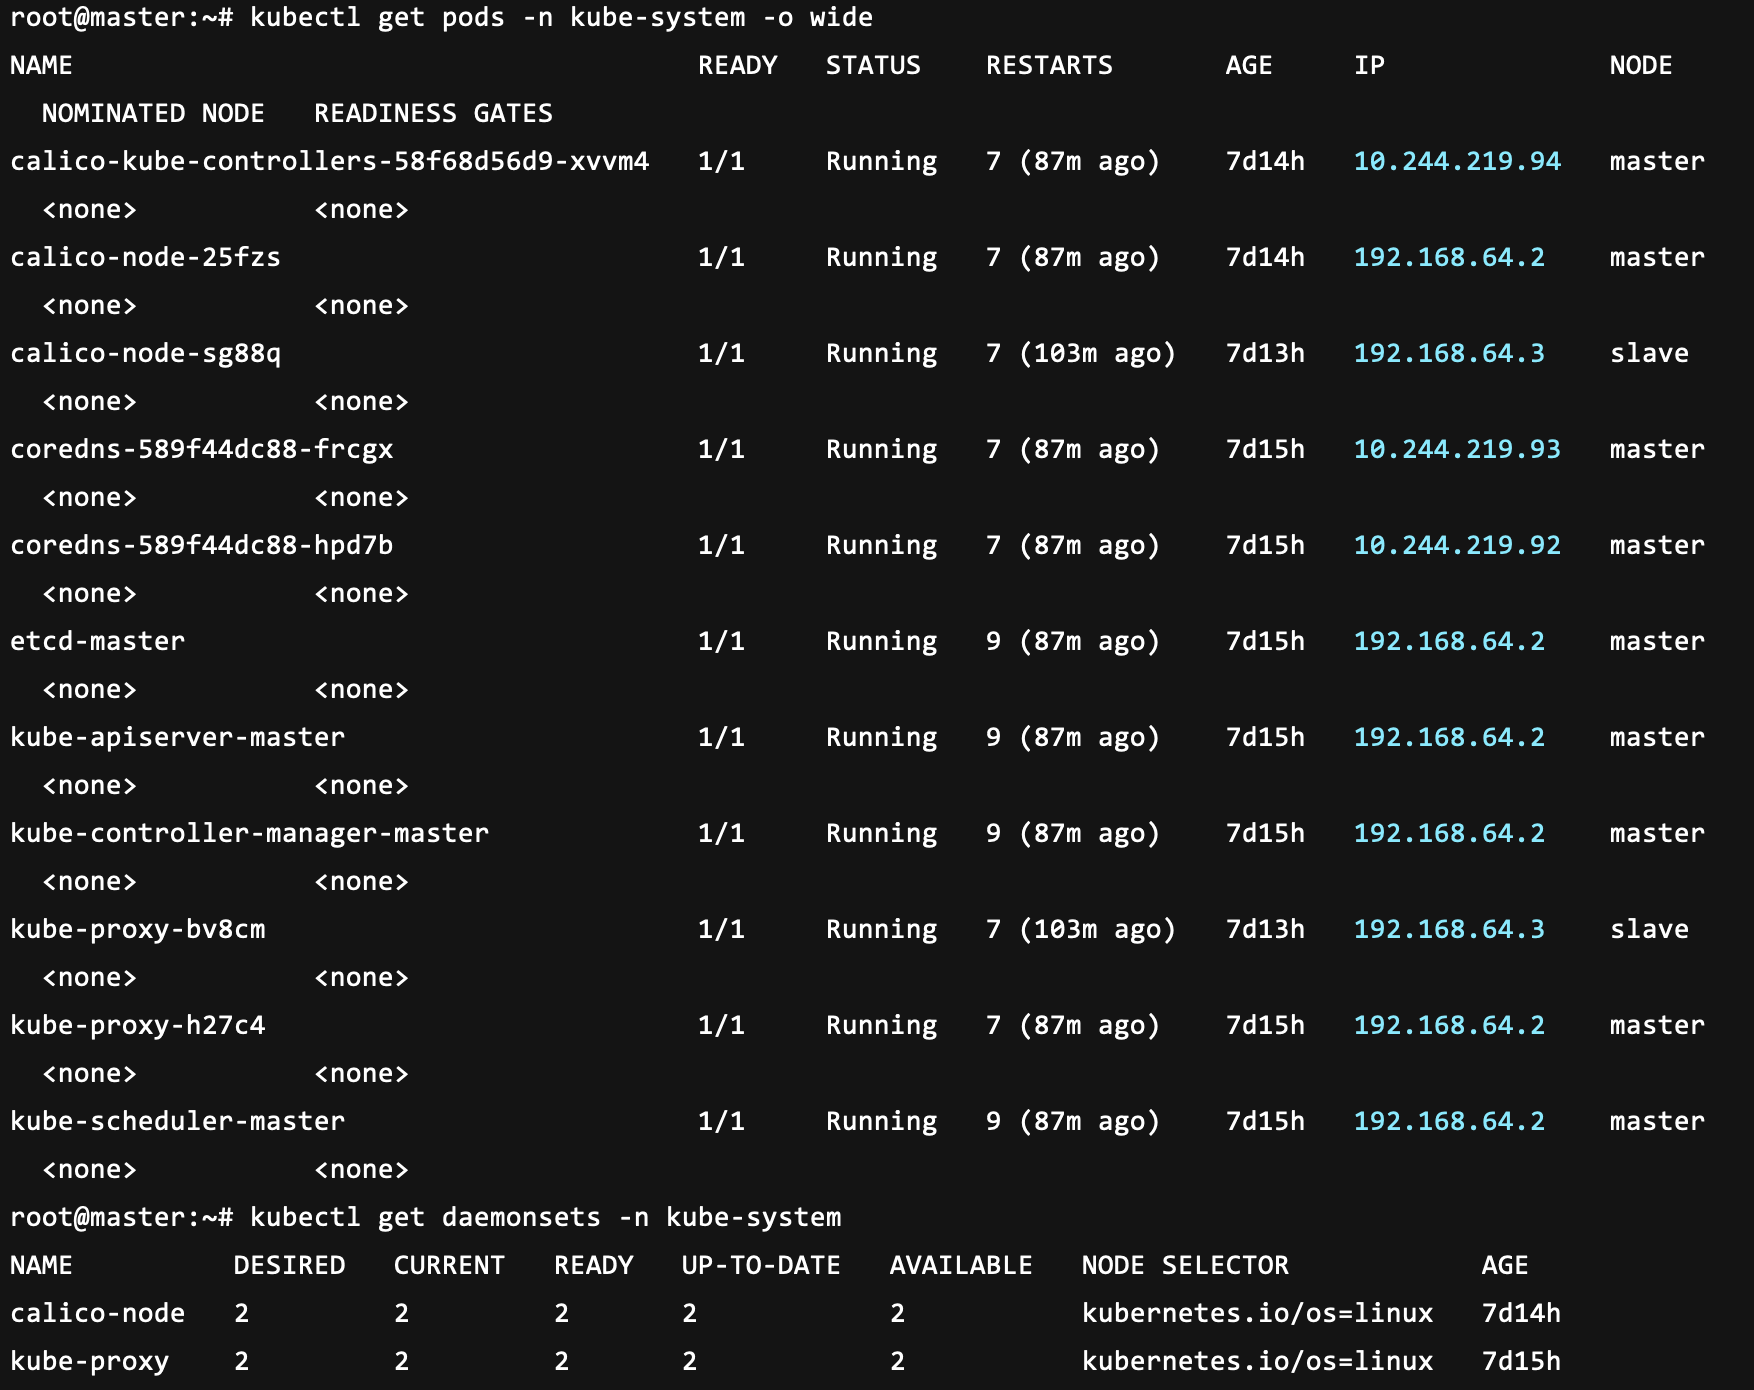
master 和 slave 节点上分别都有一个 calico-node 和 kube-proxy Pod;同时可以确认它们都是由 DaemonSet 管理的,因此会在每个符合条件的节点上运行一个 Pod;CoreDNS 则不是这种模式,它不要求每个节点运行一个实例
Pod IP 是怎么来的
当前集群使用 containerd 作为容器运行时,创建 Pod 时,运行时会先创建 Pod Sandbox,也就是经常说的 pause 容器,然后 CNI 插件给这个 Sandbox 配置网卡和 IP,业务容器再加入这套网络,整体链路体现为
kubelet
  -> CRI 容器运行时,例如 containerd
  -> 创建 Pod Sandbox
  -> 调用 CNI,例如 Calico
  -> 为 Pod 配置网卡、IP 和路由
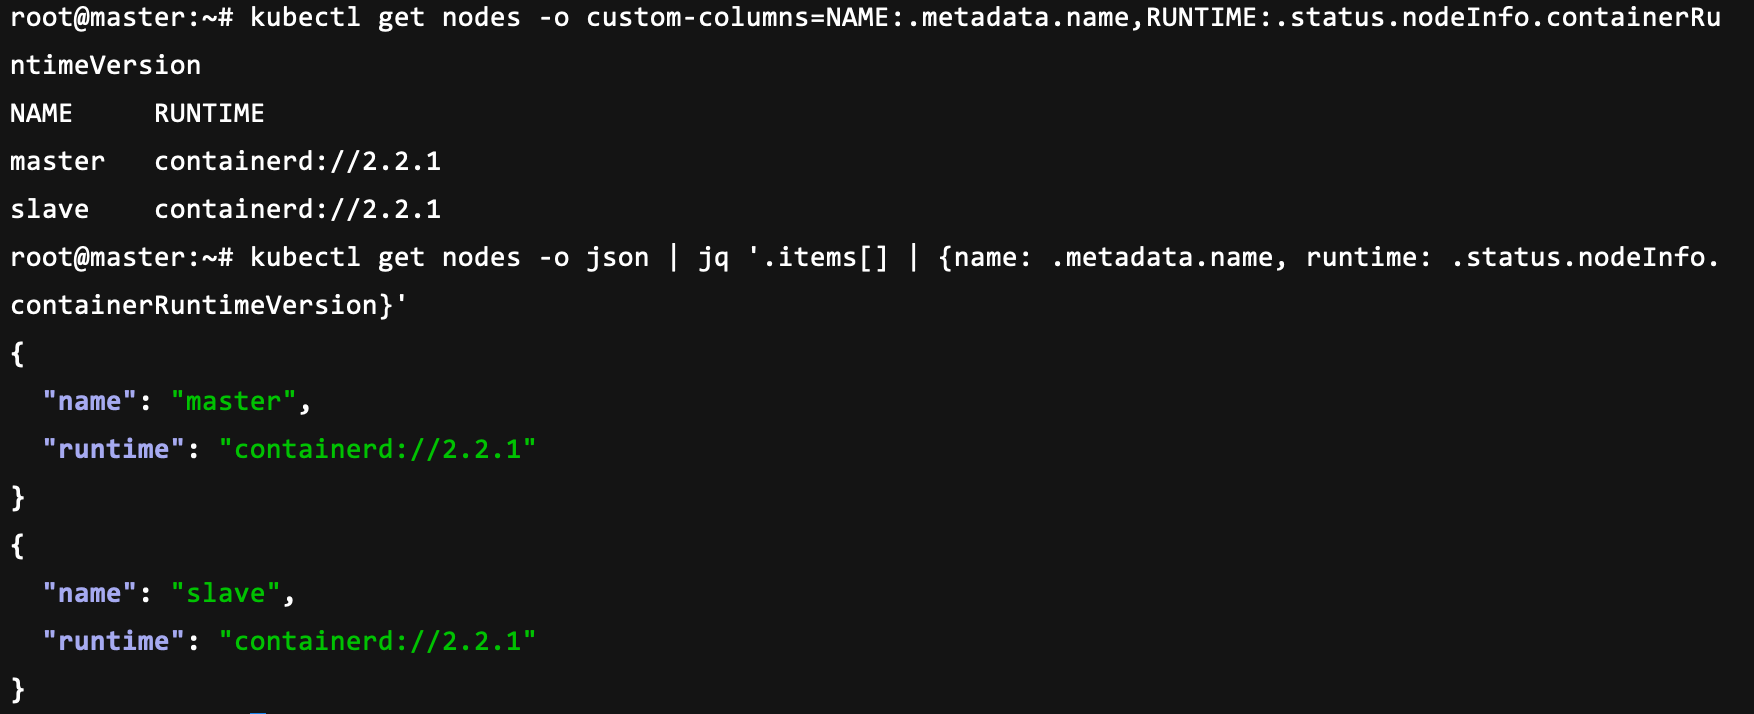
可以看看两个节点使用的运行时
kubectl get nodes -o custom-columns=NAME:.metadata.name,RUNTIME:.status.nodeInfo.containerRuntimeVersion

# 使用 json 格式查看
# kubectl get nodes -o json | jq '.items[] | {name: .metadata.name, runtime: .status.nodeInfo.containerRuntimeVersion}'
kubectl create deployment network-nginx --image=nginx:latest --replicas=3

# 查看 network-nginx 的 Deployment 的滚动更新状态,并等待它完成
kubectl rollout status deployment network-nginx

kubectl get pods -l app=network-nginx -o wide

curl {Pod_IP}
Pod 一般都会被调度到 slave,因为 master 有 control-plane 的污点;每个 Pod 会有不同的 10.244.x.x 地址,这个网段就是我们安装 Calico 时配置的 Pod 网段
在 master 上直接访问其中一个 Pod IP,如果可以看到 Nginx 页面,说明 master 到 slave 上的 Pod 网络是通的
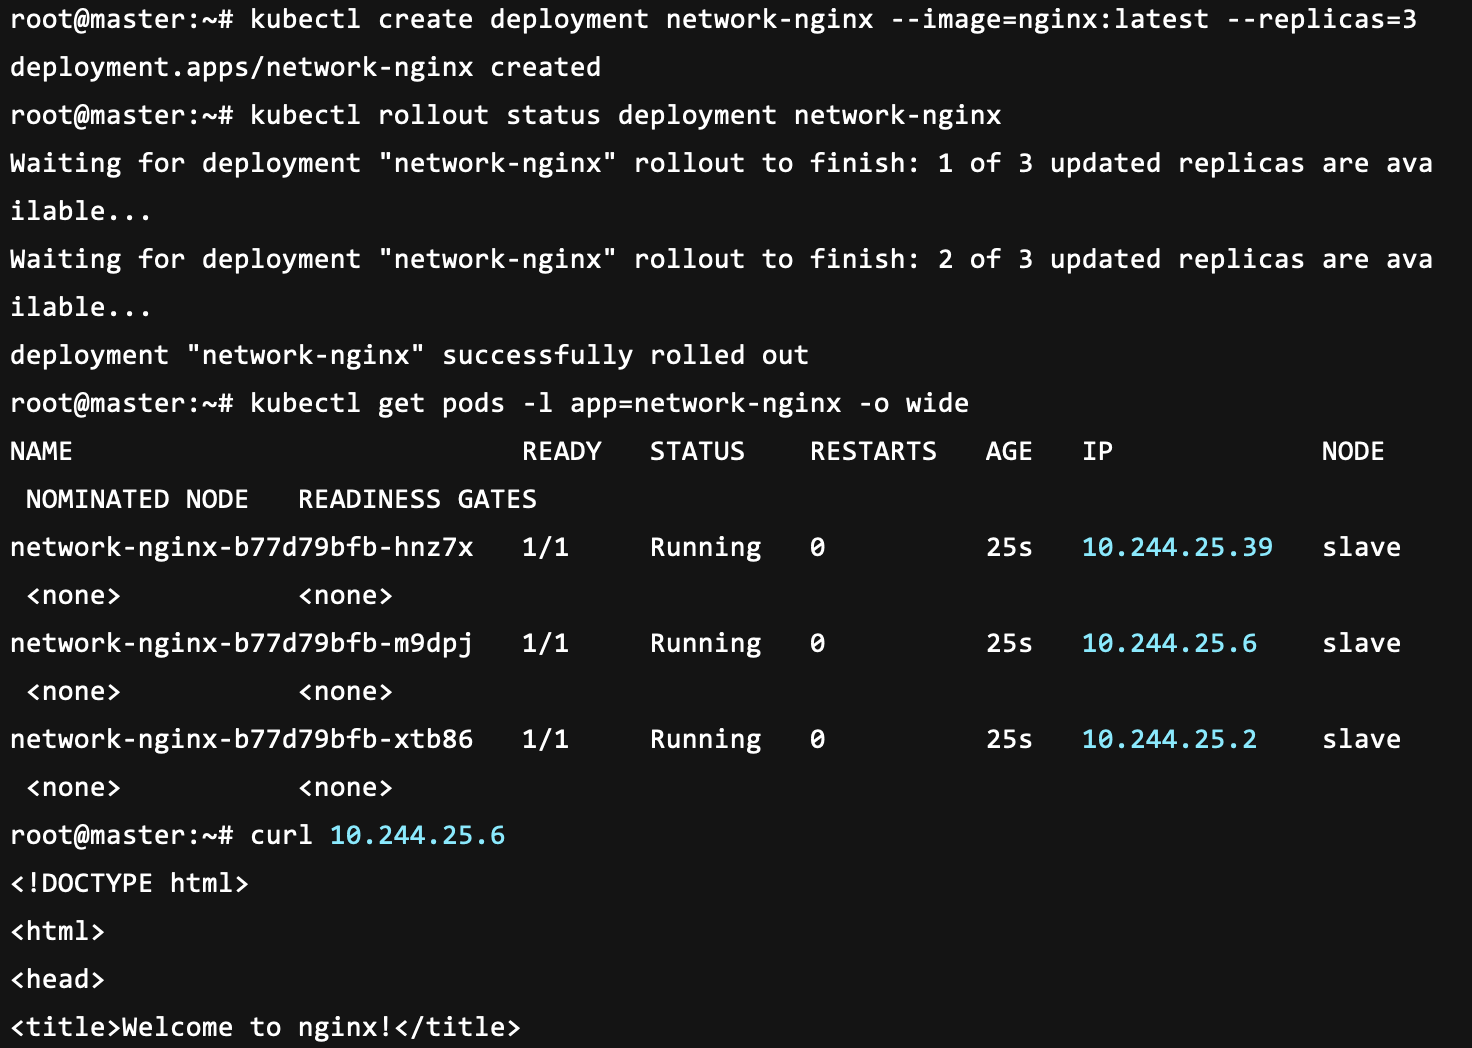
10.244.1.10,明天它就可能变成 10.244.1.16,这就有点麻烦了
Service 就是用来解决这个问题的
Service
Service 是一组 Pod 的稳定入口,它通过标签选择 Pod,对外提供一个不会因为 Pod 重建而改变的 名称 和 ClusterIP
这里需要注意,Service 并不认识 Deployment,它只是查看 Pod 标签;只要标签符合 selector,不管这个 Pod 是 Deployment、StatefulSet 创建的,还是我们手动创建的,都可以成为 Service 的后端
给刚才的 Nginx 创建 Service
cat > network-service.yaml <<'EOF'
apiVersion: v1
kind: Service
metadata:
  name: network-nginx
spec:
  selector:
    app: network-nginx
  ports:
  - name: http
    protocol: TCP
    port: 8080
    targetPort: 80
  type: ClusterIP
EOF

kubectl apply -f network-service.yaml

kubectl get service network-nginx -o wide

curl {CLUSTER-IP}:8080
这里的几个端口很容易搞混
- port 是 Service 提供的端口,其他 Pod 可以通过 8080 访问这个 Service
- targetPort 是后端应用真正监听的端口,也就是 Nginx 的 80
- 如果 Service 类型是 NodePort,还会有 nodePort,用于通过 NodeIP:nodePort 从节点外部访问 Service
可以看到,通过 curl 这个端口,可以访问到 Nginx
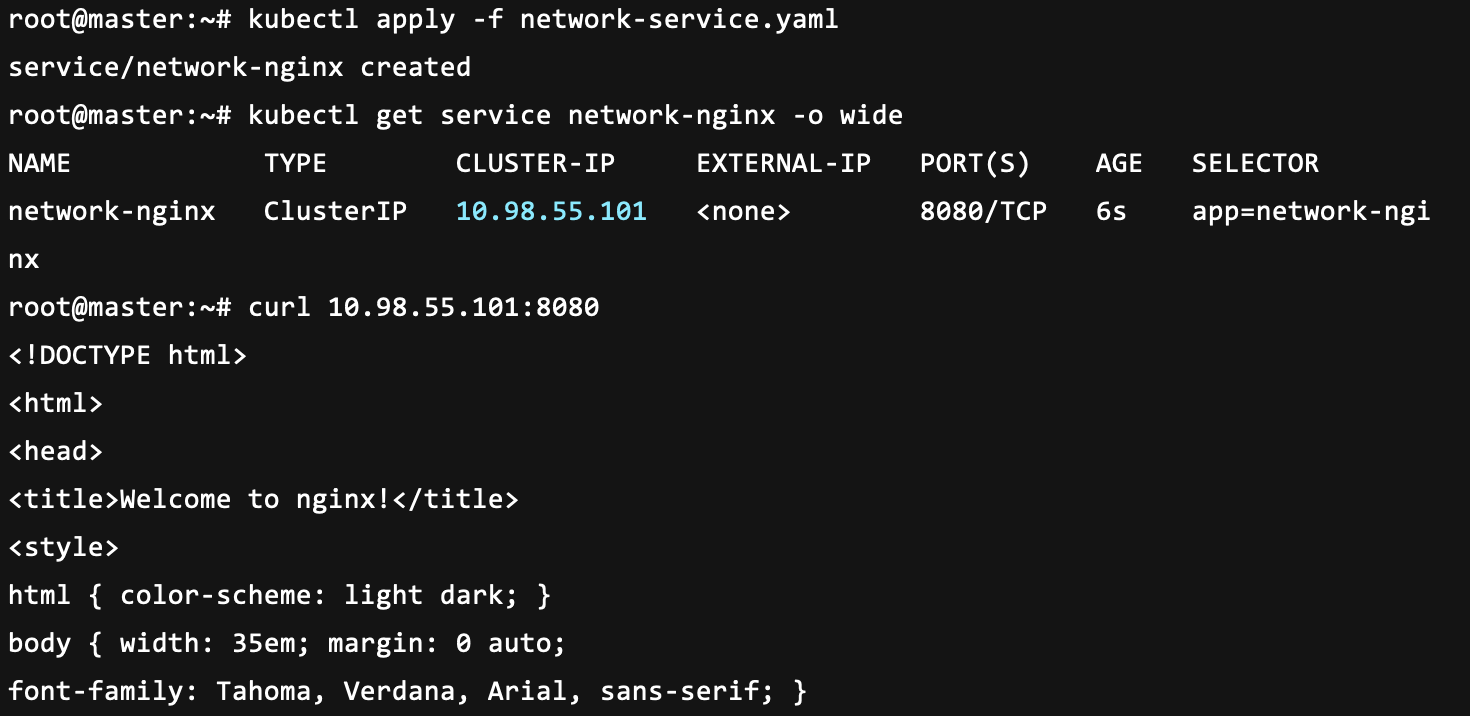
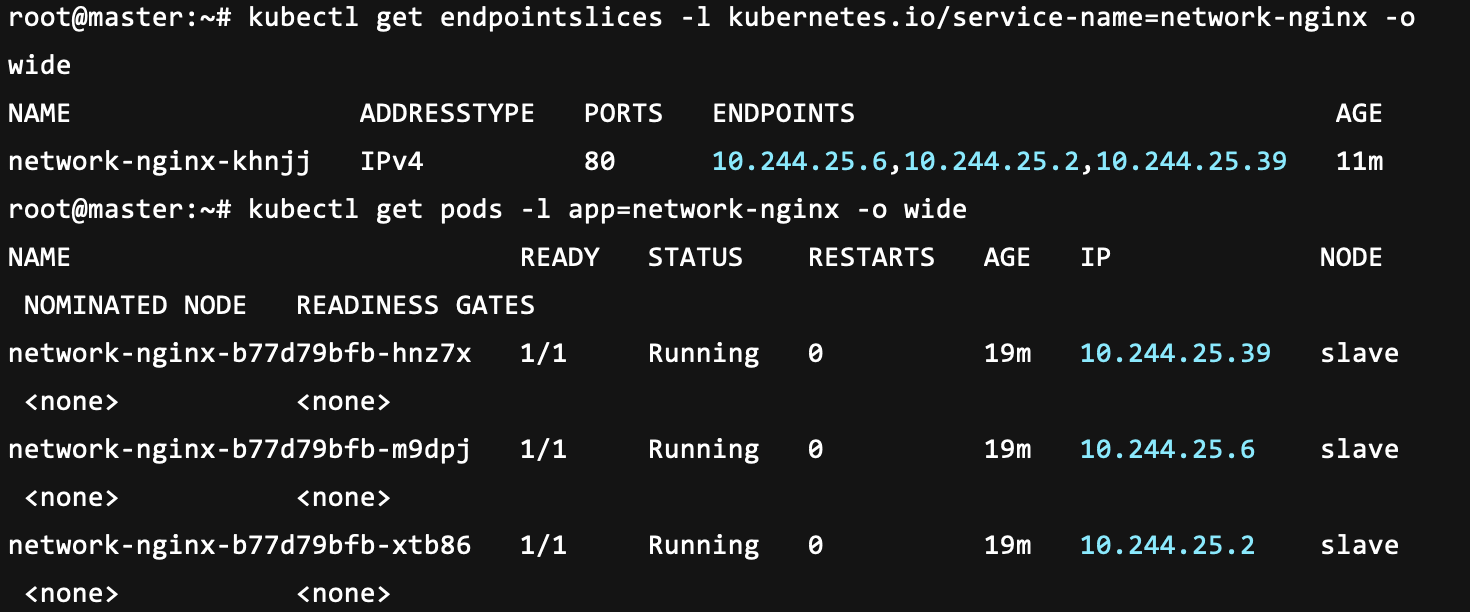
Service 选择出来的 Pod IP 会保存在 EndpointSlice 中,把它和 Pod IP 对比一下,会发现里面就是刚才三个 Nginx Pod 的地址
kubectl get endpointslices -l kubernetes.io/service-name=network-nginx -o wide
EndpointSlice 下一章再讲
Service 类型
Service 常见的类型有 ClusterIP、NodePort、LoadBalancer、ExternalName
- ClusterIP 通过集群内部 IP,暴露服务,ClusterIP 是 ServiceType 的默认值
- NodePort 通过每个节点上的 IP 和静态端口(NodePort),暴露服务,由于其是在节点上的,所以具有,通过节点的公网 IP,访问这个服务
- LoadBalancer 使用负载均衡器向外部暴露服务;外部负载均衡器可以将流量路由到自动创建的 NodePort 服务和 ClusterIP 服务上,需要云平台服务提供商的支持,分配公网 IP 才能使用
- ExternalName 通过返回 CNAME 和对应值,可以将服务映射到 externalName 字段的内容(例如,foo.bar.example.com ) ## ClusterIP ClusterIP 是默认类型,只能在集群内部访问,也是应用之间调用最常用的方式
例如 Web 调用 Redis,不需要让 Redis 暴露到公网,只需要创建 ClusterIP,然后通过 Service 名称连接即可
如果把 ClusterIP 设置为 None,它就会变成 Headless Service,不再提供虚拟 IP,而是通过 DNS 返回后端地址(先了解)
NodePort
NodePort 会在节点上开放一个端口,默认端口范围是 30000-32767
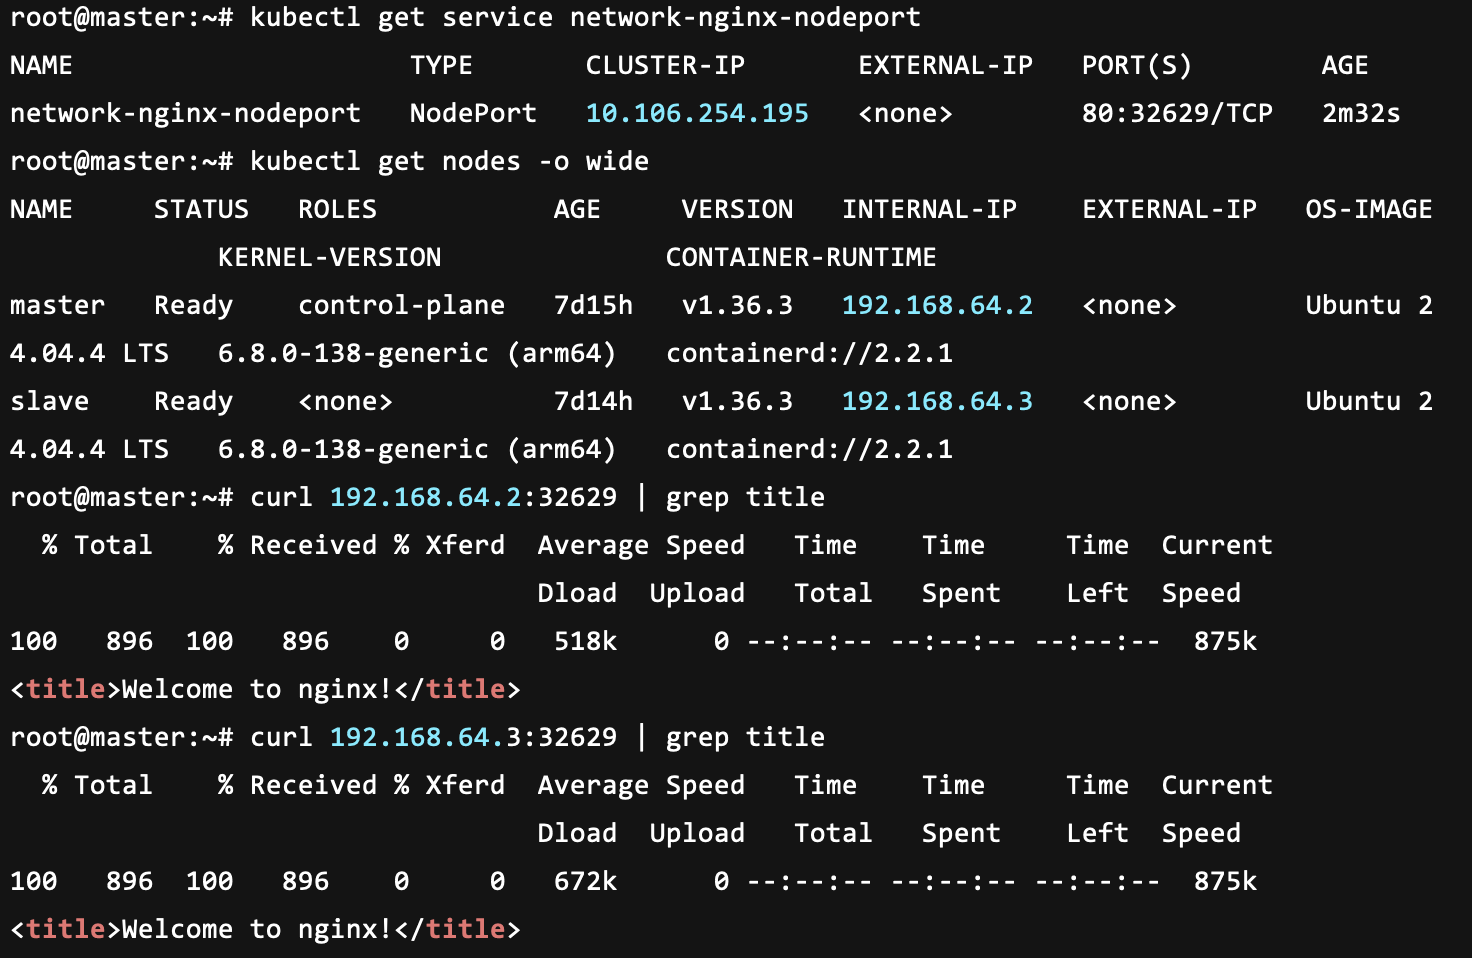
kubectl expose deployment network-nginx --name=network-nginx-nodeport --type=NodePort --port=80 --target-port=80

kubectl get service network-nginx-nodeport

kubectl get nodes -o wide

curl {master_ip}:{port}

curl {salve_ip}:{port}
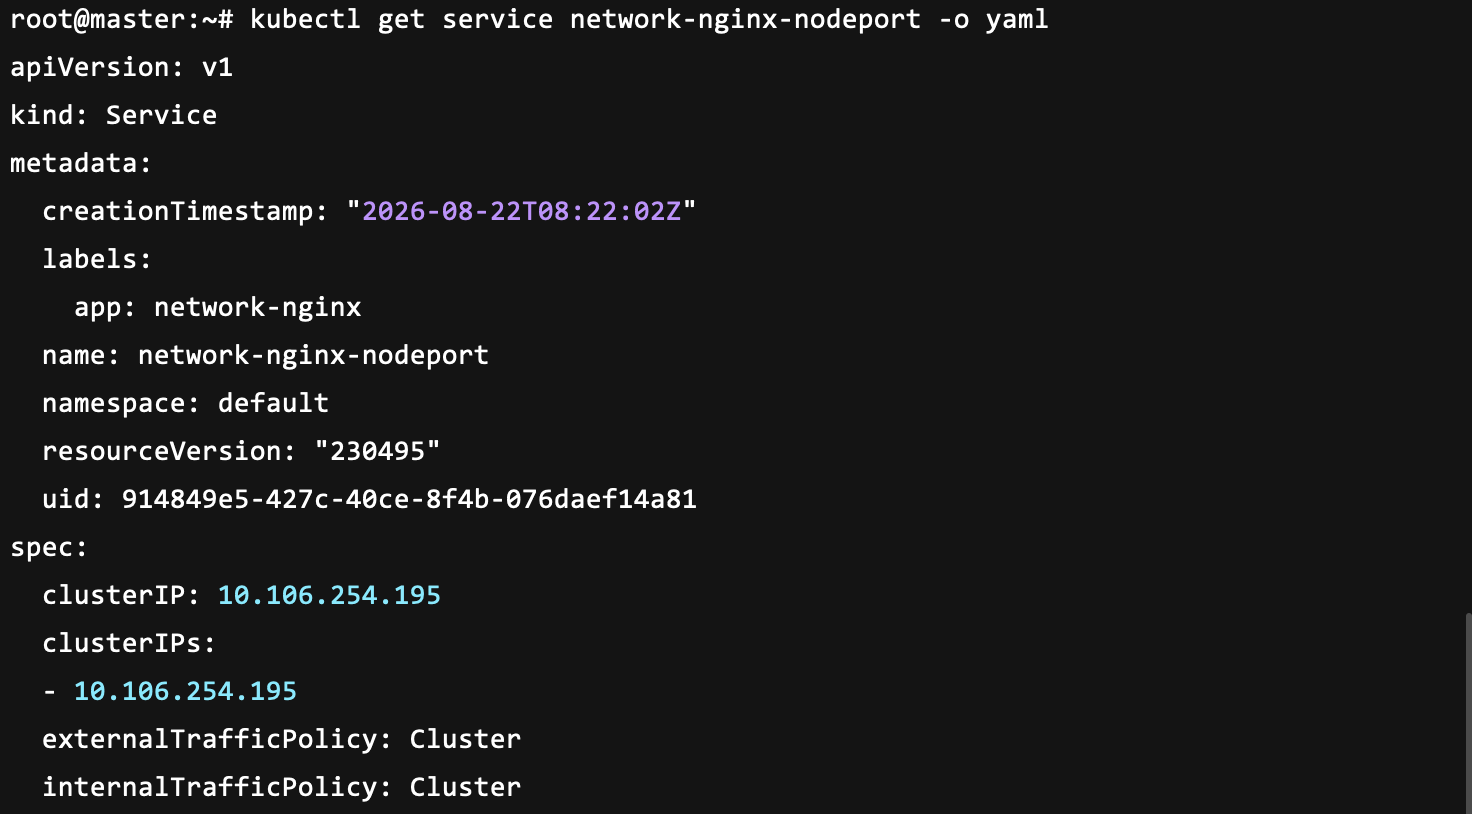
kubectl get service network-nginx-nodeport -o yaml
可以看到,默认的 externalTrafficPolicy 是 Cluster,即使请求进入 master,而后端 Pod 都在 slave,流量也可以继续转发过去;如果设置为 Local,那就只会转发给当前节点上的后端
另外,大家在本地或者服务器上开发时,一般都会喜欢用回环地址,也就是 127.0.0.1,但在 Kubernetes 中,不要把 127.0.0.1:{NodePort} 当成固定用法,能不能通过环回地址访问跟 kube-proxy 模式和配置有关,使用节点实际 IP 会更加稳妥一些
LoadBalancer
LoadBalancer 用于获得集群外部入口,但 Kubernetes 只定义了这个对象怎么写,并不会自己变出一个公网 IP
公有云一般会有云控制器帮我们创建负载均衡器;本地 虚拟机 或 裸机集群 则需要 MetalLB、kube-vip 等实现,如果集群没有这些东西,创建之后会一直看到
EXTERNAL-IP <pending>
LoadBalancer 默认还会分配 NodePort,不过现在也可以根据负载均衡器实现,设置 allocateLoadBalancerNodePorts: false,直接把流量送往 Pod
这里我没有装额外负载均衡器,知道它为什么 Pending 即可
ExternalName
ExternalName 类型的 Service 不负责把流量转发到 Pod,它只是把 Kubernetes 集群里的一个 Service 名称,解析成另一个外部域名
cat > external-name.yaml <<'EOF'
apiVersion: v1
kind: Service
metadata:
  name: external-api
spec:
  type: ExternalName
  externalName: api.example.com
EOF

kubectl apply -f external-name.yaml

# 临时启动一个 Pod,在 Pod 查询这个 Service 的 CNAME 记录
# 验证 ExternalName 是否真的解析到了外部域名
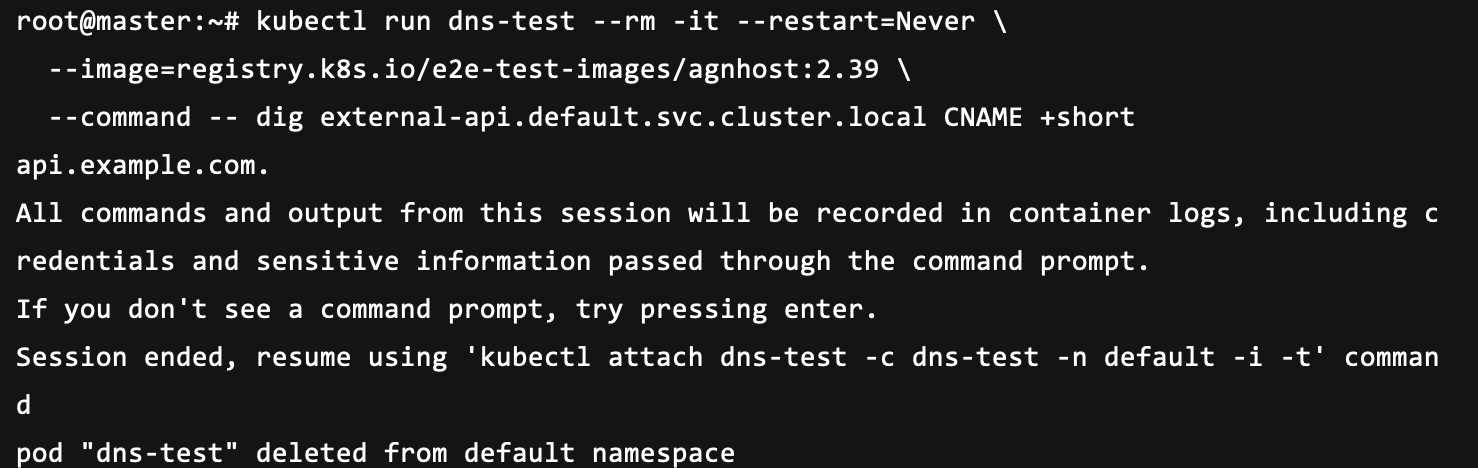
kubectl run dns-test --rm -it --restart=Never --image=registry.k8s.io/e2e-test-images/agnhost:2.39 --command -- dig external-api.default.svc.cluster.local CNAME +short
可以看到,查询 external-api 时,CoreDNS 会返回指向 api.example.com 的 CNAME
kube-proxy
前面介绍了四种 Service 类型,其中 ExternalName 只负责 DNS 别名,不会把请求转发到 Pod;ClusterIP、NodePort、LoadBalancer 虽然入口不同,但最后都要解决同一个问题:Service 后面有多个 Pod 时,请求应该交给哪一个 Pod
把前面创建的 network-nginx Service、EndpointSlice 和 Pod 放在一起查看
kubectl get service network-nginx -o wide

kubectl get endpointslices -l kubernetes.io/service-name=network-nginx -o wide

kubectl get pods -l app=network-nginx -o wide
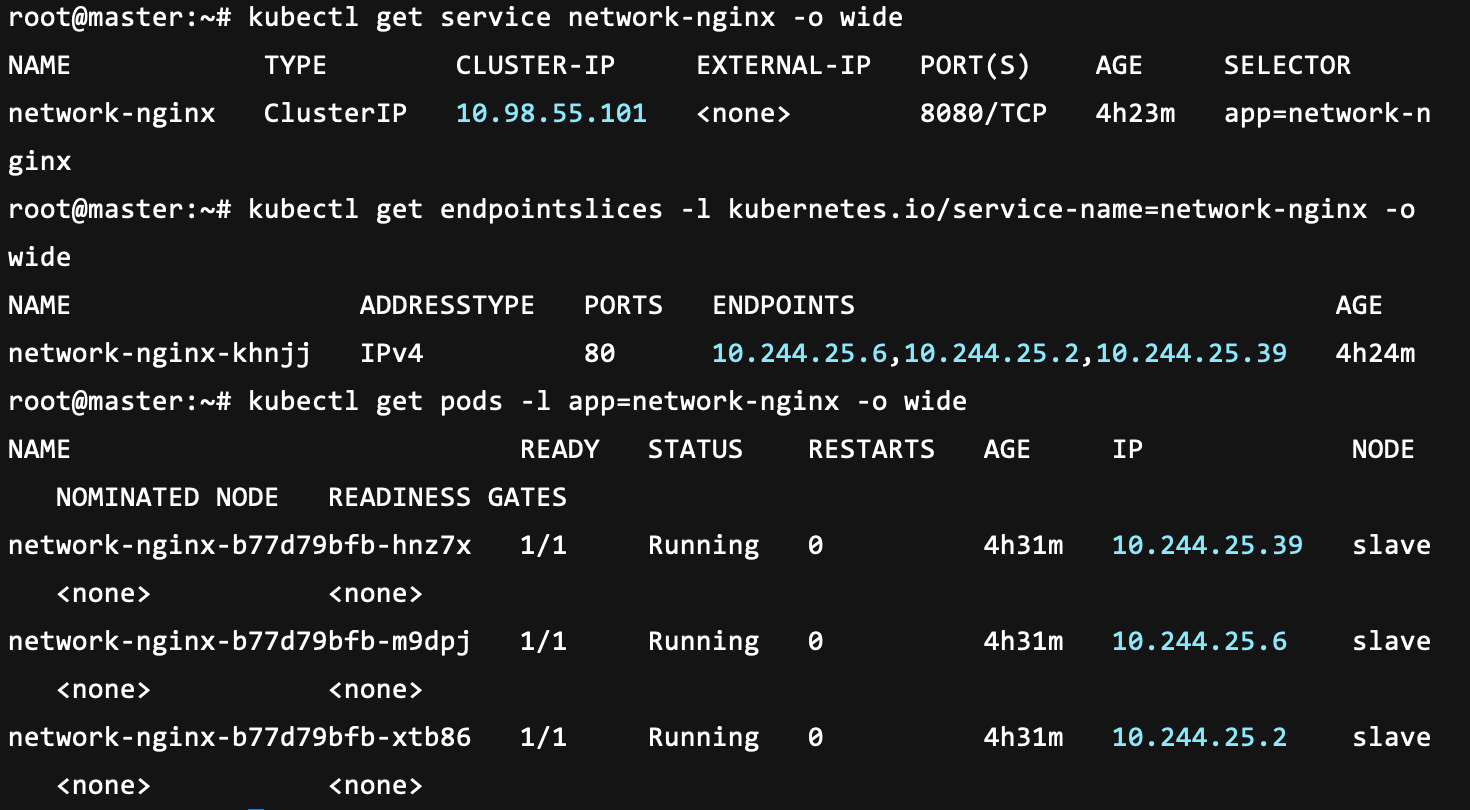
真正把 Service 入口和后端 Pod 连接起来的是 kube-proxy
kube-proxy 会在每个节点上运行,它持续关注 Service 和 EndpointSlice:创建 Service 时,它为新的 ClusterIP 准备转发规则;Pod 增加、删除或者就绪状态发生变化时,它再根据 EndpointSlice 更新这些规则
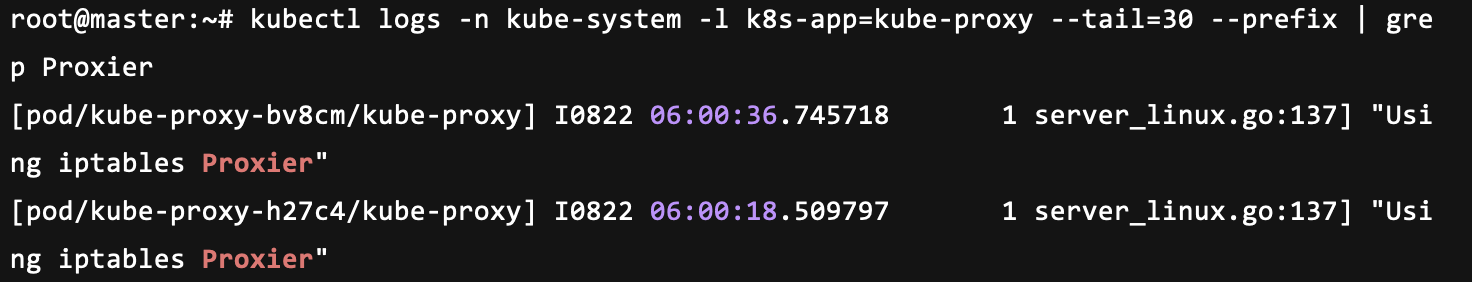
kubectl logs -n kube-system -l k8s-app=kube-proxy --tail=30 --prefix
可以看到,当前使用的是 iptables 模式
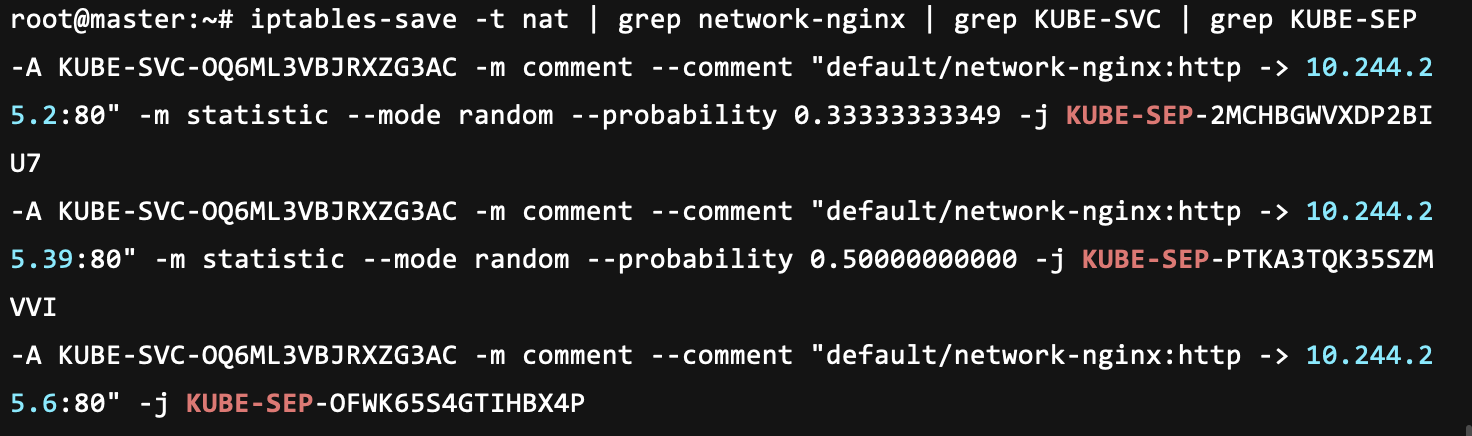
iptables-save -t nat | grep network-nginx | grep KUBE-SVC | grep KUBE-SEP
在 iptables 中,一个 Service 对应一条 KUBE-SVC 链,而每个后端 Pod 对应一条 KUBE-SEP 链,当前 network-nginx 有三个 Pod,因此它的 KUBE-SVC 后面连接了三个 KUBE-SEP
kube-proxy 通过 statistic、random、probability 规则在三个后端之间进行近似均匀选择:第一条从全部请求中选择约 1/3,第二条从剩余请求中选择 1/2,也就是总请求的 1/3,最后剩余的 1/3 进入第三个 Pod
由于当前三个 Nginx Pod 都在 slave 上,如果请求是从 master 发出的,地址转换完成后,还要由 Calico 把数据包送到 slave 上的 Pod;因此 kube-proxy 解决的是 Service 怎样选择和转发到 Pod,Calico 解决的是数据包怎样跨节点到达这个 Pod
kube-proxy 这个名字也容易让人误会,在当前使用的 iptables 模式中,请求不会先进入 kube-proxy 进程
kube-proxy 负责的是维护规则,而真正匹配规则和转换地址的是 Linux 内核
这也解释了 Service 为什么能够作为稳定入口:Pod 被删除重建后,ClusterIP 不需要改变,EndpointSlice 会记录新的 Pod IP,kube-proxy 再把节点上的转发规则更新掉即可
在现在 Linux 上可用的代理模式有 iptables、nftables、IPVS
- iptables 当前集群使用的模式,通过 iptables 规则随机选择后端
- nftables 作用和 iptables 相同,但使用新的 nftables API,在大量 Service 和 Pod 的集群中扩展性更好,从 Kubernetes 1.33 开始稳定
- IPVS 使用 Linux 内核的 IPVS 功能,可以配置轮询、最少连接等调度算法,但从 Kubernetes 1.35 开始已经弃用
这三种模式只是 kube-proxy 实现转发规则的不同方式,并不是请求依次经过的三个阶段
Service 提供稳定入口
  -> EndpointSlice 记录后端 Pod
  -> kube-proxy 根据两者维护节点规则
  -> Linux 内核选择一个 Pod 并转换目标地址
  -> Calico 把数据包送到这个 Pod
最后,来看看,每个组件都是干什么的
- CoreDNS 把 Service 名称解析成 ClusterIP
- Service 提供稳定的 ClusterIP 和端口
- EndpointSlice 保存当前可用的后端 Pod 地址
- kube-proxy 根据 Service 和 EndpointSlice 配置转发规则
- Calico 提供 Pod IP、路由和跨节点通信
总结
这一章看起来讲了很多东西,其实核心就是两点
Pod 有自己的 IP,但是 Pod 会变;Service 提供了稳定入口,解决了 Pod IP 变化问题,然后通过 EndpointSlice 可以找到后面的 Pod
至于 iptables、nftables、CNI 路由这些东西,第一次接触不可能全部弄清楚,我也不太懂说实话...
愿诸君顺遂