(十五)服务发现
前面我们学习了外部用户怎样通过域名和路径进入集群,今天我们来看看集群内部的应用是怎样找到彼此的
Pod IP 会随着重建而变化,所以应用不能把另一个 Pod 的 IP 写死在配置里;Service 虽然有稳定的 ClusterIP,但 ClusterIP 也是 Kubernetes 分配的,应用同样不应该提前知道它是多少
应用真正需要记住的应该是一个稳定名称,例如 mysql、redis、user-api,再由 Kubernetes 把这个名称解析成当前可以访问的地址,这个过程就是服务发现
比如你知道我叫 Ray,你想找我但不知道我住哪;你去公安局询问,然后找到了我(bushi —— 这就是服务发现
Kubernetes 主要提供两种发现 Service 的方式
- DNS
- 环境变量
实际使用中以 DNS 为主,先从它开始
使用 DNS 发现 Service
创建两个命名空间,discovery-b 中运行服务,discovery-a 中运行客户端
kubectl create namespace discovery-a

kubectl create namespace discovery-b

kubectl create deployment discovery-web -n discovery-b --image=nginx:latest --replicas=2

kubectl rollout status deployment discovery-web -n discovery-b

kubectl expose deployment discovery-web -n discovery-b --port=8080 --target-port=80

# 查看
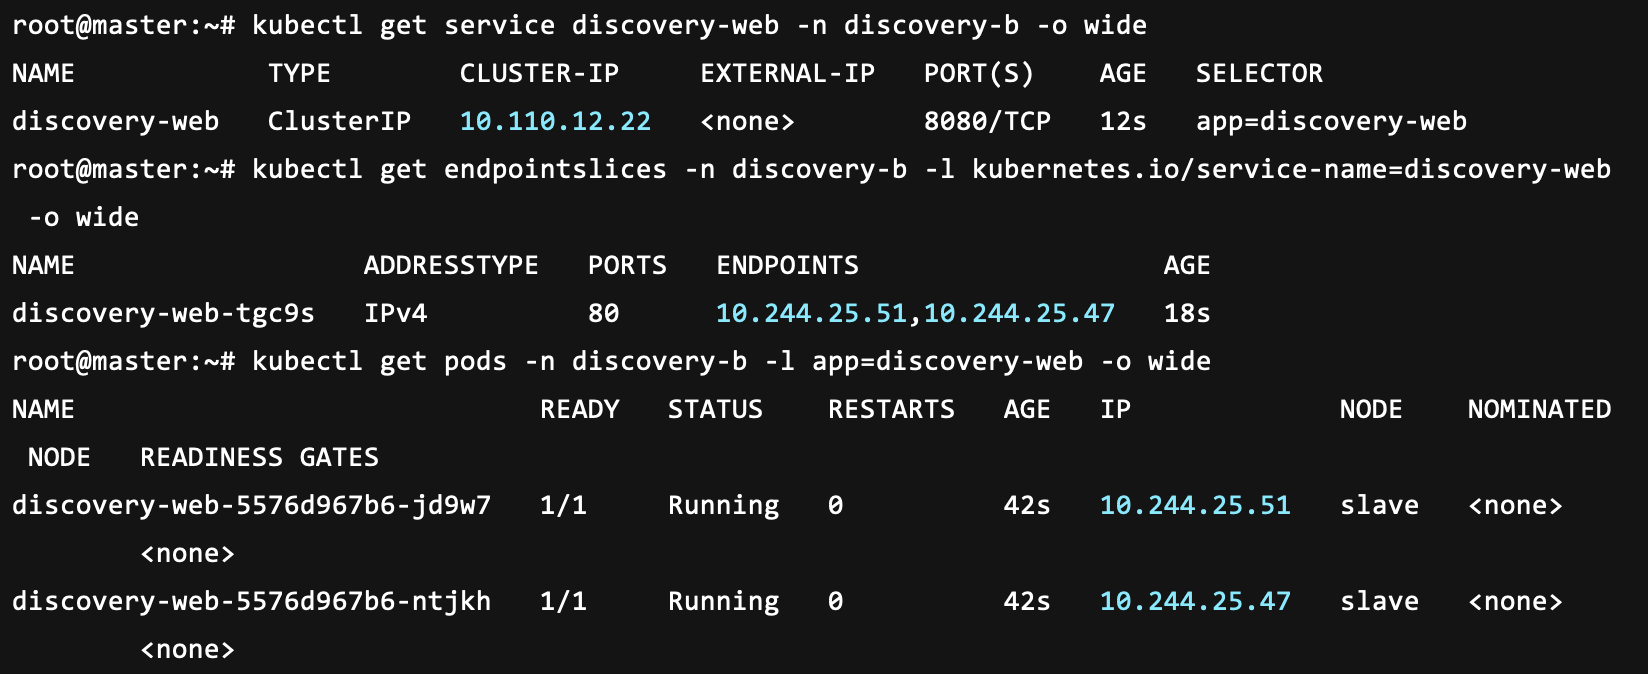
kubectl get service discovery-web -n discovery-b -o wide

kubectl get endpointslices -n discovery-b -l kubernetes.io/service-name=discovery-web -o wide

kubectl get pods -n discovery-b -l app=discovery-web -o wide
Service 有一个稳定的 ClusterIP,EndpointSlice(电话簿)中是两个 Nginx Pod 的 IP;客户端最后访问哪一个 Pod 仍然由前面学过的 Service 转发规则决定
现在在另一个命名空间创建一个专门查询 DNS 的 Pod
kubectl run dns-client -n discovery-a --image=busybox:1.36 --restart=Never --command -- sleep 3600

kubectl wait pod dns-client -n discovery-a --for=condition=Ready --timeout=120s

# 只查询 Service 的短名称
kubectl exec -n discovery-a dns-client -- nslookup discovery-web

# 带上 Service 所在的命名空间查询
kubectl exec -n discovery-a dns-client -- nslookup discovery-web.discovery-b

# 使用完整名称查询
kubectl exec -n discovery-a dns-client -- nslookup discovery-web.discovery-b.svc.cluster.local
第一项查询,不出意外的话会出现 NXDOMAIN;第二项查询... 可能是 BusyBox 的问题,BusyBox 自带的 nslookup 遇到名称中已经包含点号时,会直接向 DNS 服务器查询 discovery-web.discovery-b,没有按照 Pod 的搜索域补成 Kubernetes 中真正存在的完整名称
但是使用完整名称查询则可以查询到与 Service 相同的 ClusterIP,这说明,说明 Service 的 DNS 记录确实存在
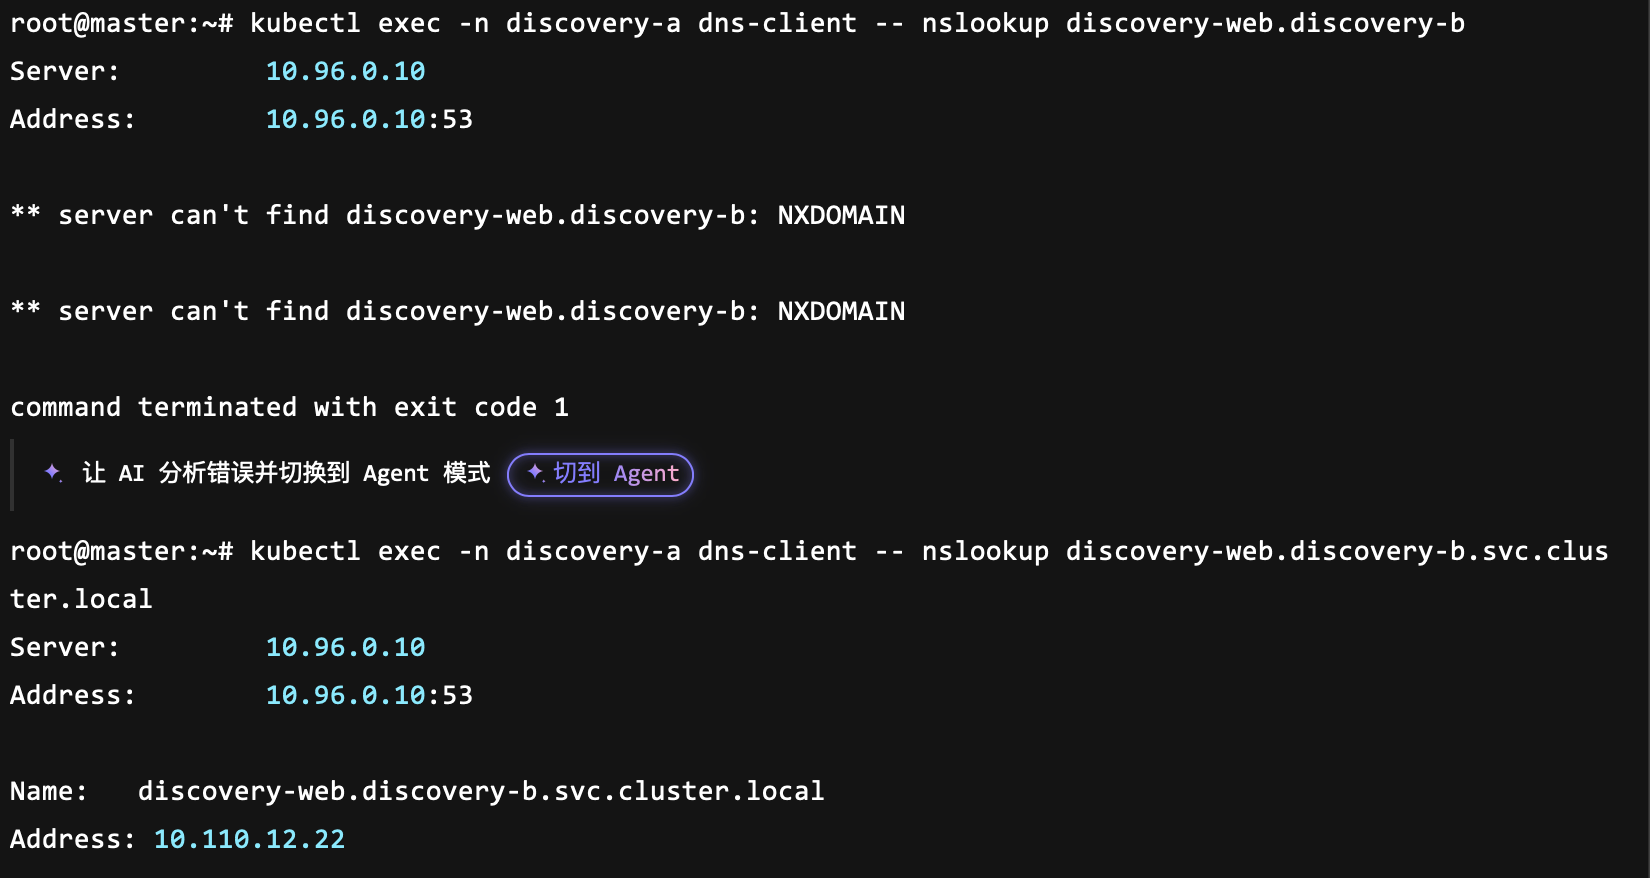
{Service名称}.{命名空间}.svc.cluster.local其中cluster.local是常见的集群域名,也可以在安装 Kubernetes 时改成别的值;排查 DNS 时直接使用完整名称最明确,不会受到不同命令怎样处理搜索域的影响
普通应用通常会使用 Pod 中的系统解析器,它会读取 /etc/resolv.conf 中的搜索域,因此跨命名空间访问时可以简写成 Service名称.命名空间
仍然在同一个 BusyBox Pod 中,使用 wget 访问 Nginx
kubectl exec -n discovery-a dns-client -- wget -qO- http://discovery-web.discovery-b:8080
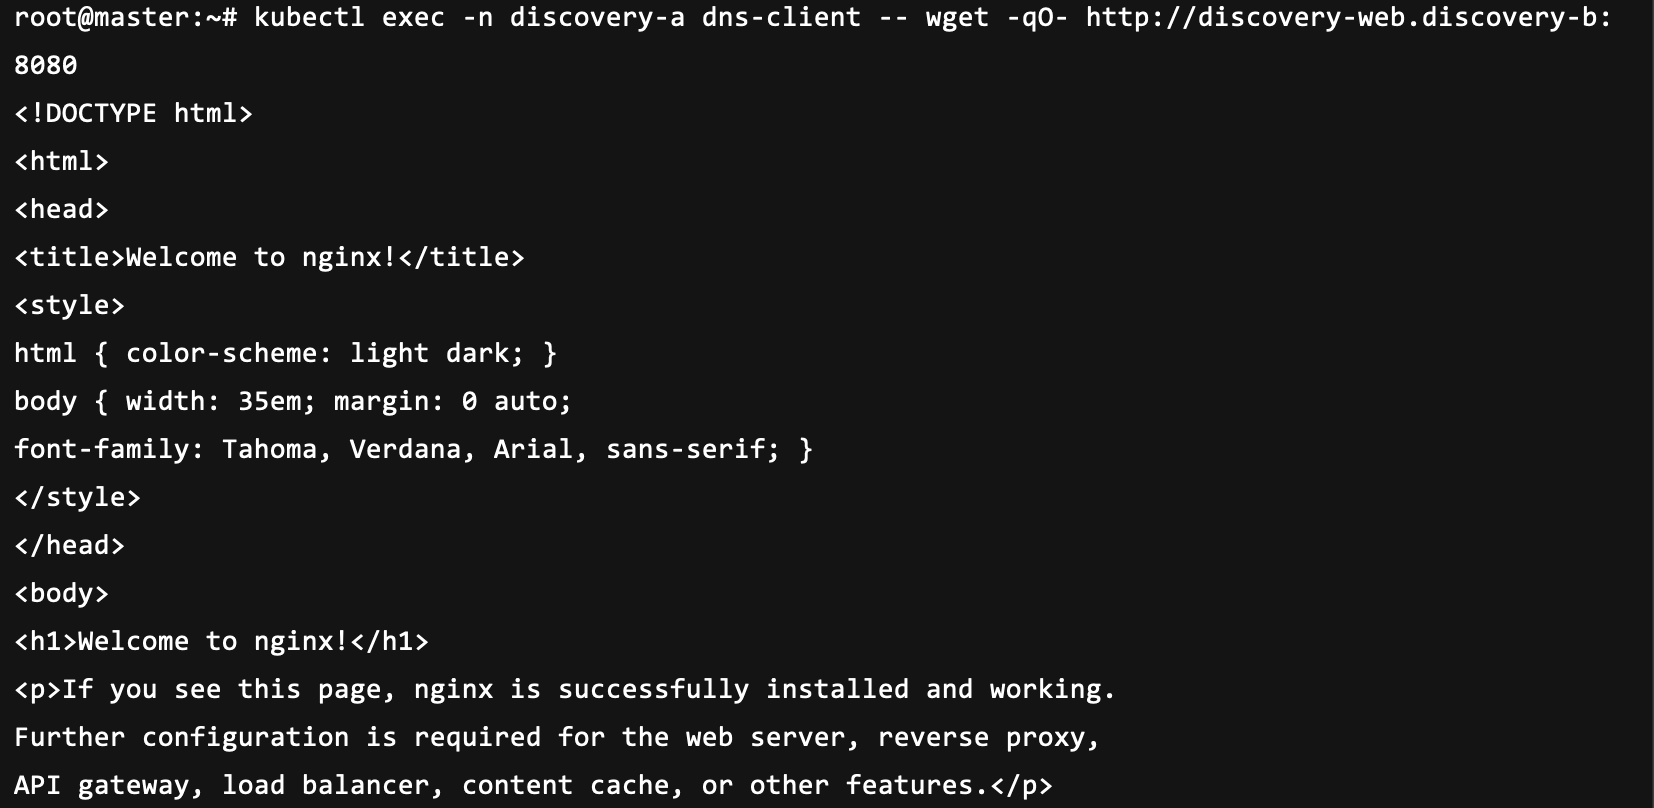
wget 使用的解析过程会尝试补全搜索域,最终把名称补成 discovery-web.discovery-b.svc.cluster.local;所以同一个短名称可能在 BusyBox 的 nslookup 中失败,却能被应用正常使用
现在来梳理一下请求经过
discovery-web.discovery-b
  -> Pod 中的解析器补全 .svc.cluster.local
  -> CoreDNS 解析出 Service ClusterIP
  -> kube-proxy 规则选择 EndpointSlice 中的一个 Pod
  -> Nginx Pod:80
从上述请求就可以知道,DNS 负责找到 Service 的稳定入口,EndpointSlice 和 kube-proxy 负责从 Service 到 Pod,它们解决的问题是不同的
CoreDNS 做了什么
# 查看集群中的 DNS 组件
kubectl get deployment coredns -n kube-system

kubectl get pods -n kube-system -l k8s-app=kube-dns -o wide

kubectl get service kube-dns -n kube-system -o wide

kubectl get endpointslices -n kube-system -l kubernetes.io/service-name=kube-dns -o wide
可以看到,现在的 Kubernetes 通常运行 CoreDNS Pod,但它的 Service 为了兼容仍然叫 kube-dns
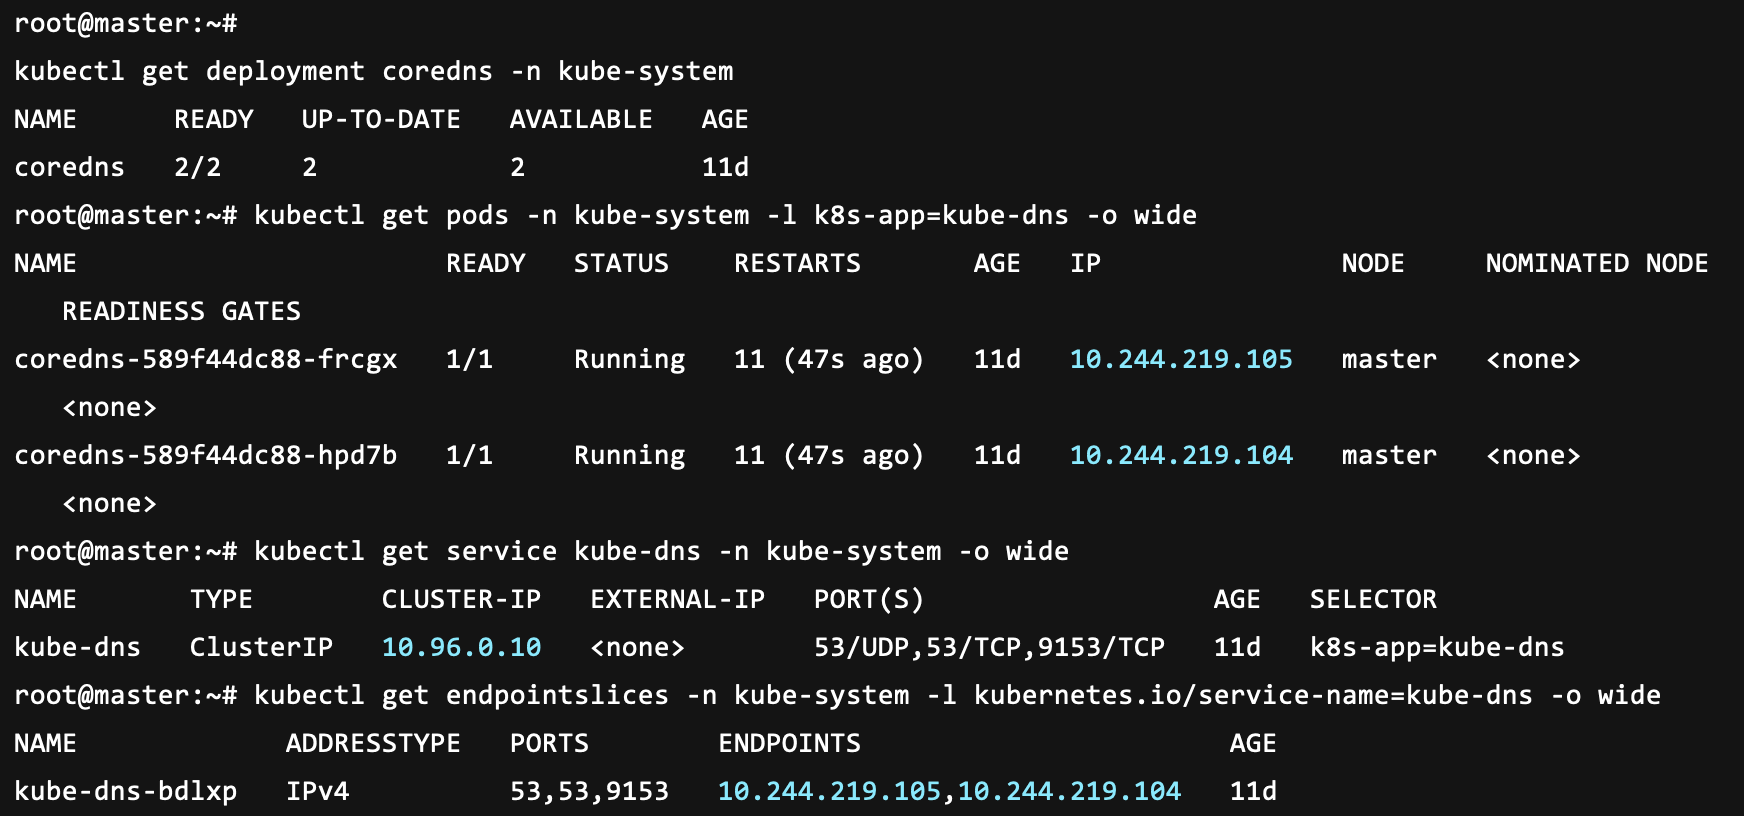
10.96.0.10,然后 CoreDNS 持续观察 Kubernetes API 中的 Service 和 EndpointSlice,再回答对应的集群内名称
# 查看客户端 Pod 的 DNS 配置
kubectl exec -n discovery-a dns-client -- cat /etc/resolv.conf
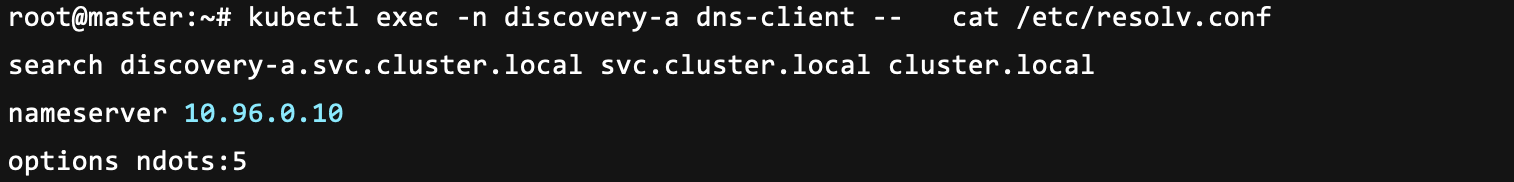
nameserver 是集群 DNS Service 的地址,search 是系统解析器补全名称时依次尝试的域,ndots:5 表示少于 5 个点号的名称通常会先尝试搜索域
比如,应用查询 discovery-web.discovery-b 时,系统解析器会依次尝试搜索域,其中 svc.cluster.local 可以把它补成 discovery-web.discovery-b.svc.cluster.local;只查询 discovery-web 时,则会先按客户端自己的命名空间补成 discovery-web.discovery-a.svc.cluster.local,不会自动猜测 Service 位于哪个其他命名空间
搜索域是否生效还取决于具体程序使用哪一种解析实现,当前 BusyBox 的 wget 会使用这些搜索域,但它自带的 nslookup 对带点号名称的处理不同,因此查询完整名称才不会出现 NXDOMAIN
Headless Service
普通 Service 的 DNS 名称解析成一个 ClusterIP,客户端只看到 Service,再由 kube-proxy 选择 Pod
有些应用不希望中间存在 ClusterIP,例如数据库集群的客户端需要直接知道所有成员的地址,这时可以创建 Headless Service
cat > discovery-headless.yaml <<'EOF'
apiVersion: v1
kind: Service
metadata:
  name: discovery-headless
  namespace: discovery-b
spec:
  clusterIP: None
  selector:
    app: discovery-web
  ports:
  - name: http
    protocol: TCP
    port: 8080
    targetPort: 80
EOF

kubectl apply -f discovery-headless.yaml

kubectl get service discovery-headless -n discovery-b

kubectl exec -n discovery-a dns-client -- nslookup discovery-headless.discovery-b.svc.cluster.local

kubectl get pods -n discovery-b -l app=discovery-web -o wide
在 get service 中,我们可以看到 CLUSTER-IP 是 None,说明这个 Service 没有虚拟 IP,而后我们通过 DNS 查询,看到了两个 Address 正好与 Pod 的中的 IP 是相同的
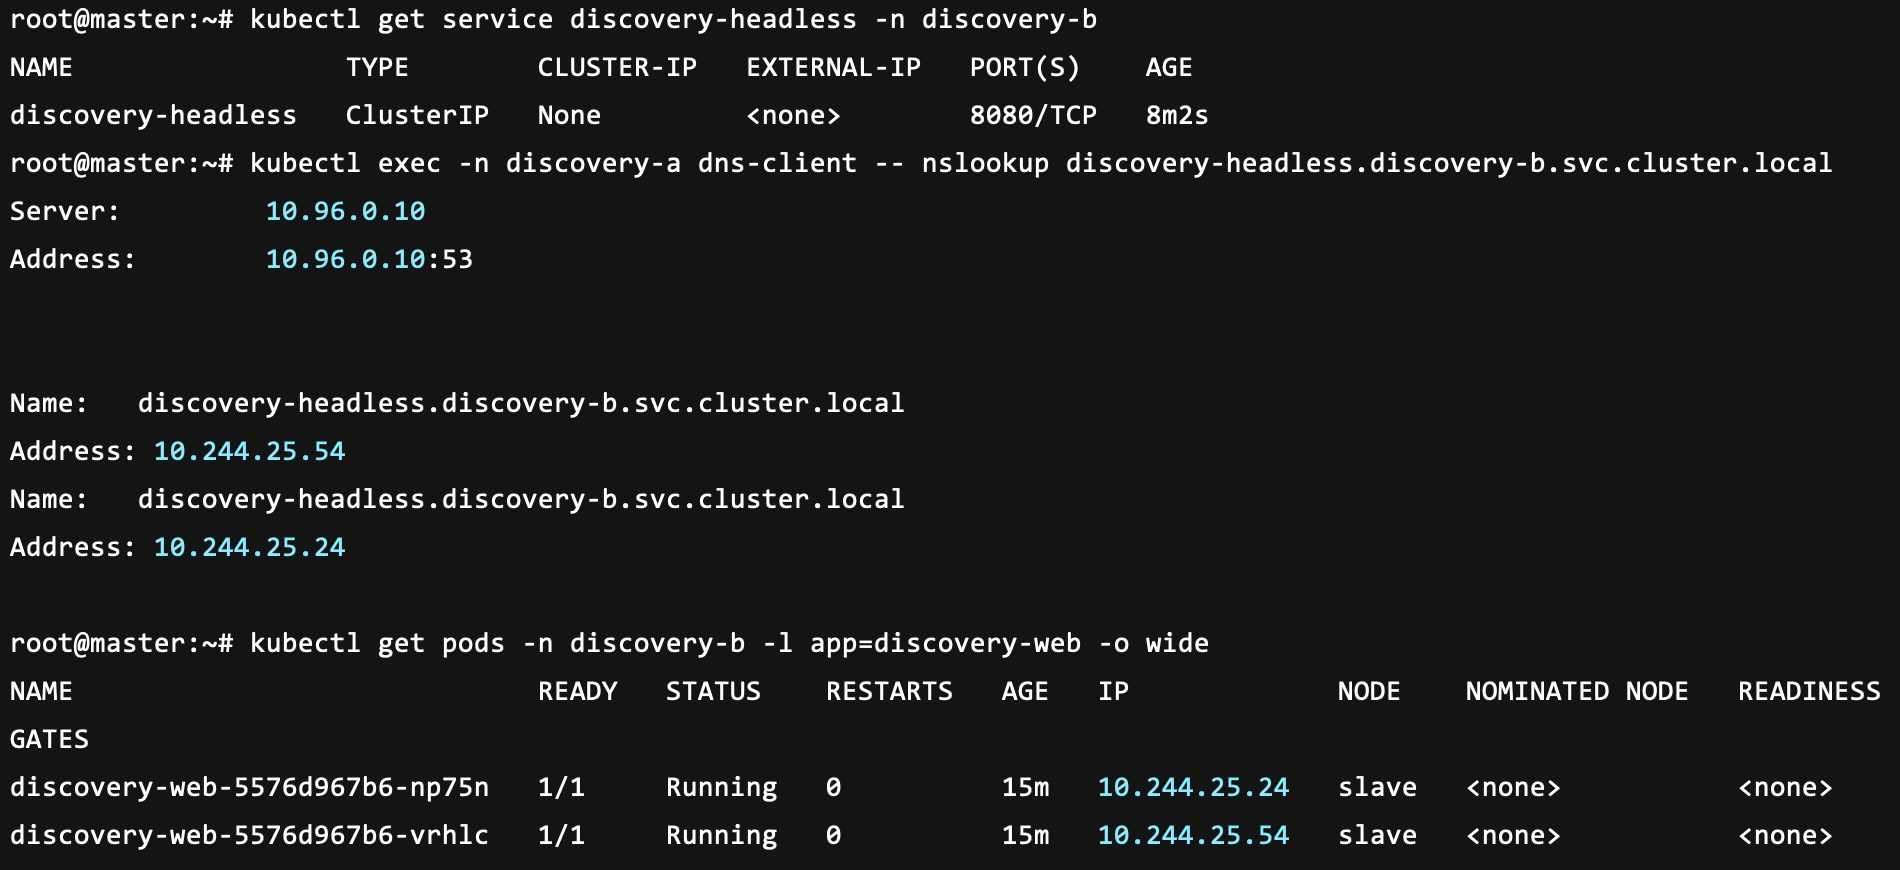
一个普通 Service 名称,包含一个 CLUSTER-IP 通过 kube-proxy 选择 Pod;而 Headless Service 包含一个或多个后端 Pod IP,客户端自己去选择并连接 Pod
Headless 并不是 没有 Service,它仍然使用 selector 和 EndpointSlice,只是 DNS 不再返回 ClusterIP
StatefulSet、数据库集群和需要客户端自己发现成员的系统经常使用这种方式
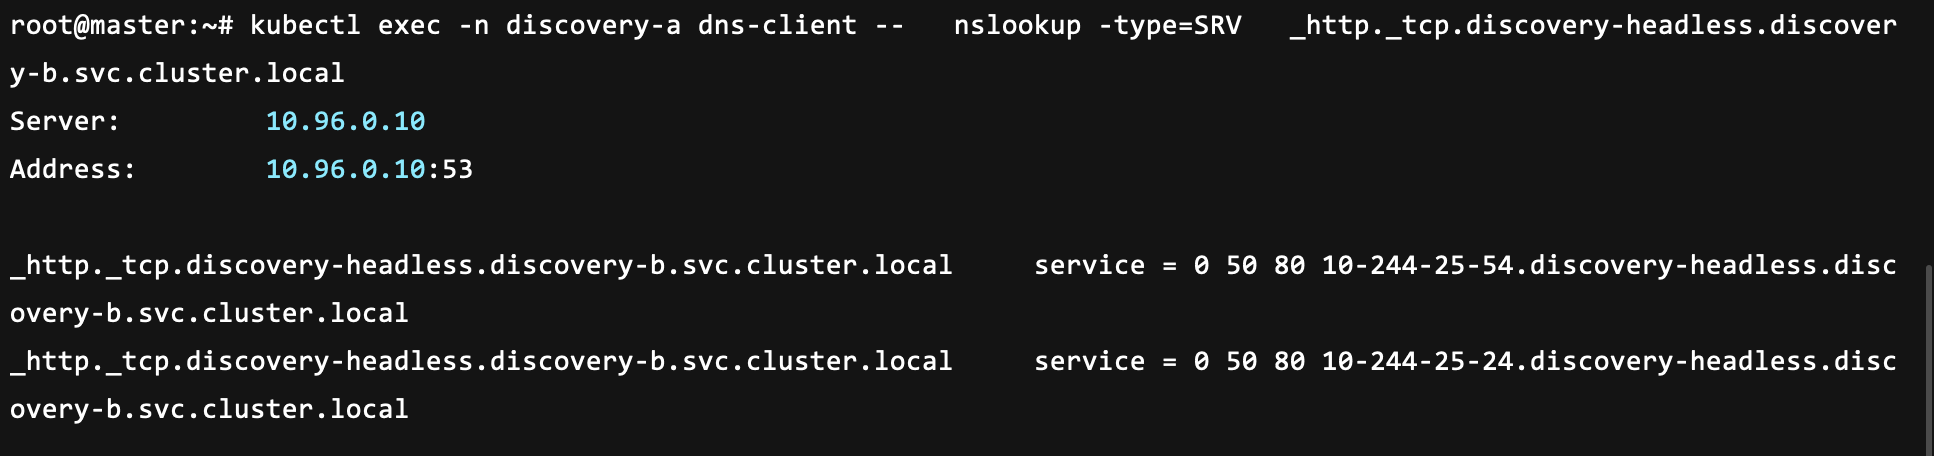
Service 端口有名称时,CoreDNS 还会提供 SRV 记录;SRV 记录是 DNS 中的一个 "服务定位" 记录,它不仅告诉客户端服务器的地址,还精准的指出应该连接哪个端口以及如何选择服务器
kubectl exec -n discovery-a dns-client -- nslookup -type=SRV _http._tcp.discovery-headless.discovery-b.svc.cluster.local
_http 来自端口名称,_tcp 来自协议,可以看到,SRV 不只告诉客户端地址,还能告诉它服务端口,Headless Service 的 SRV 记录还可以返回各个后端的名称
使用环境变量发现 Service
除了 DNS,kubelet 在创建 Pod 时,还会把同一命名空间中已经存在的 Service 写成环境变量
先创建 Service,再创建客户端 Pod
kubectl create service clusterip env-db -n discovery-b --tcp=5432:5432
kubectl run env-client -n discovery-b --image=busybox:1.36 --restart=Never --command -- sleep 3600
kubectl wait pod env-client -n discovery-b --for=condition=Ready --timeout=120s
# 查看和 `env-db` 有关的变量
kubectl exec -n discovery-b env-client -- sh -c "env | sort | grep '^ENV_DB'"
可以看到什么 DBSERVICEHOSG、xxPORT 之类的环境变变量
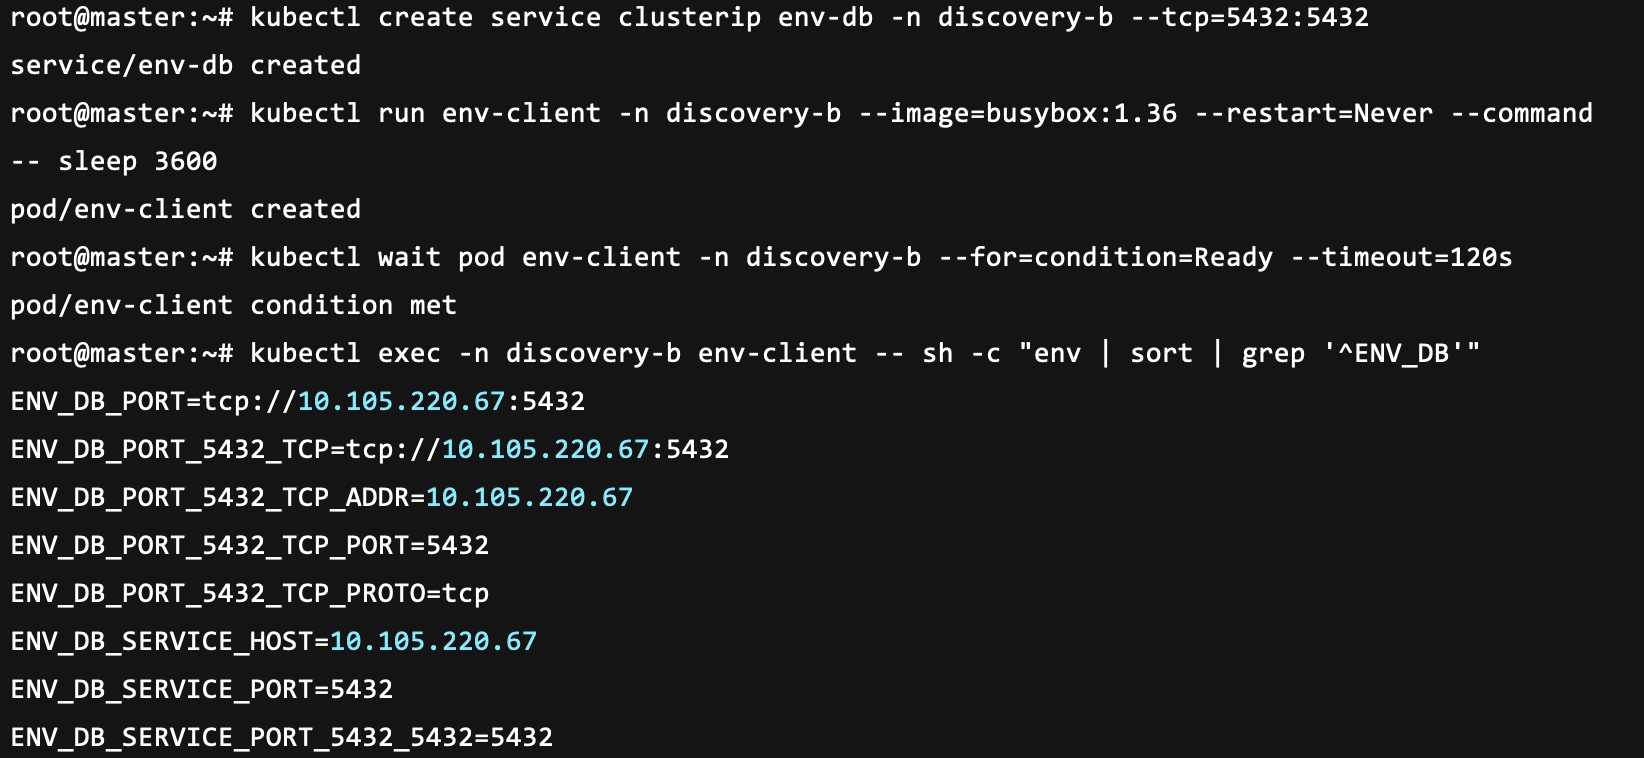
ENV_DB_SERVICE_HOST 和 `ENVDBSERVICEPORT` 取得 ClusterIP 和端口
这种方式有一个很大的限制:环境变量只在 Pod 创建时注入,所以 Service 必须先于客户端 Pod 存在;之后新建 Service,已经运行的 Pod 不会自动出现新的变量,Service 地址发生变化时,旧变量也不会动态更新
DNS 没有这个创建顺序问题,应用只保存名称,每次解析时由 CoreDNS 返回当前地址,所以普通服务发现一般优先使用 DNS
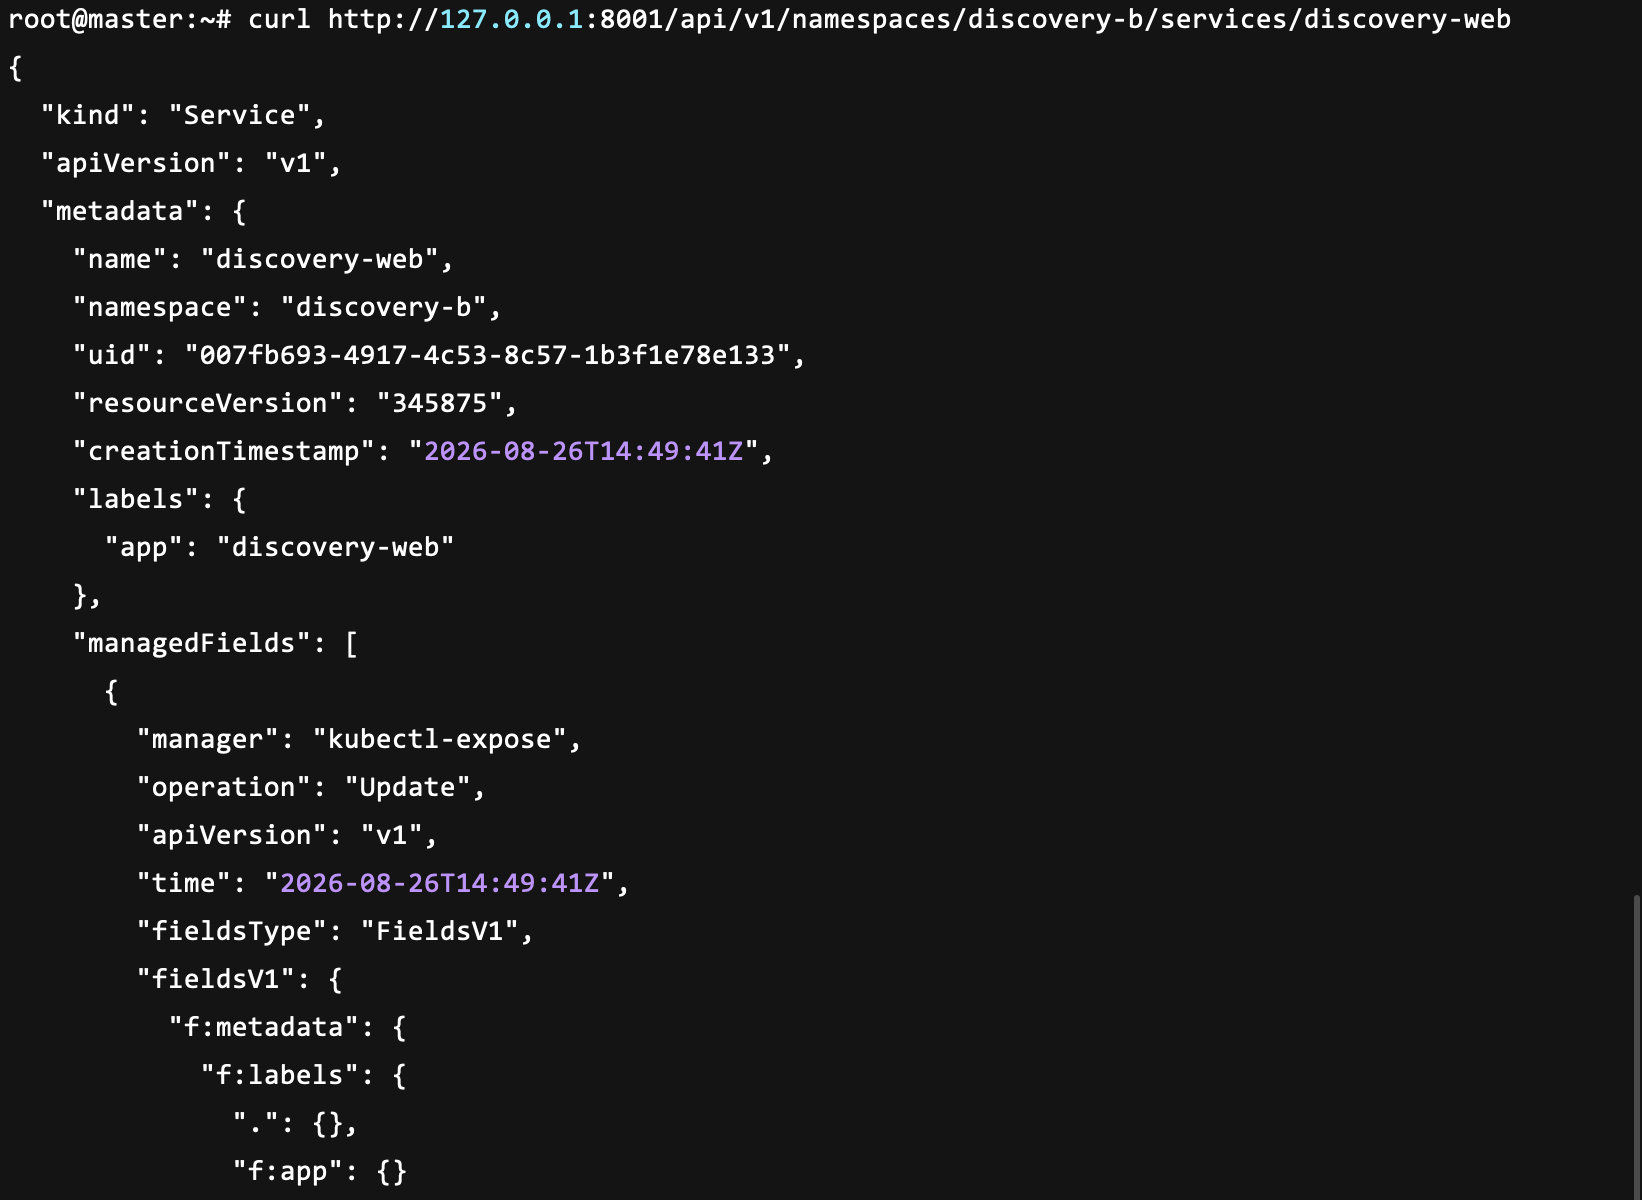
kubectl proxy 不是服务发现
kubectl proxy --port=8001

# 额外开一个执行
curl http://127.0.0.1:8001/api/v1/namespaces/discovery-b/services/discovery-web
返回的是 API Server 中保存的 Service 对象;kubectl proxy 只是让当前电脑上的客户端通过 kubeconfig 安全地访问 Kubernetes API,默认只监听 127.0.0.1,它既不会创建 NodePort,也不是给集群内应用发现服务用的,更不参与 kubeadm join
DNS 排查
Service 名称无法访问时,先在 Pod 内查询 Kubernetes 自带的 Service
kubectl exec -n discovery-a dns-client -- nslookup kubernetes.default.svc.cluster.local
如果这个名称也无法解析,再检查 Pod 的 DNS 配置和 CoreDNS
kubectl exec -n discovery-a dns-client -- cat /etc/resolv.conf
kubectl get service kube-dns -n kube-system
kubectl get endpointslices -n kube-system -l kubernetes.io/service-name=kube-dns -o wide
kubectl get pods -n kube-system -l k8s-app=kube-dns
kubectl logs -n kube-system -l k8s-app=kube-dns --tail=100
如果 DNS 能解析出 Service ClusterIP,但访问仍然失败,就不应该继续盯着 CoreDNS,而要回到 Service 和 EndpointSlice
kubectl get service discovery-web -n discovery-b -o yaml
kubectl get endpointslices -n discovery-b -l kubernetes.io/service-name=discovery-web -o yaml
重点检查 Service 端口、selector、EndpointSlice 地址和就绪状态;还要注意,节点自己的 /etc/resolv.conf 和 Pod 的 DNS 配置不一定相同,应该从真正发起请求的 Pod 内测试,不能用节点上的 nslookup 结果直接判断 CoreDNS 是否正常
# 清理环境
kubectl delete namespace discovery-a discovery-b
总结
今天这章主要讲的就是,应用怎样找到一个会变化的服务,将服务名称通过 CoreDNS 解析成 Service ClusterIP,Service 再通过 EndpointSlice 和 kube-proxy 找到后端 Pod
以及普通 Service 的 DNS 返回 ClusterIP,Headless Service 的 DNS 直接返回后端地址;环境变量也能提供 Service 地址,但受 Pod 创建顺序限制,实际使用通常以 DNS 为主
到这,Kubernetes 的网络部分,我们算是初步讲解完成了,当然,你会发现这些文章的质量不太高,没错,我也是个小白,我搜索资料也是靠各种网站和AI,质量参差不齐,很难产出一篇说让你从头明白到尾的博客
当然,我对这些文章,其实也不是很满意,因为他始终没让我明白,知识是具有连贯性的...
愿诸君顺遂