(一)初识 Prometheus
今天我们来学习一下什么是 Prometheus,从 0 开始理解的话,它会比较抽象,但不需要担心,因为我刚开始学习的时候也一样
1、Prometheus 是什么
Prometheus 本质上是一个监控系统,但从我个人角度来看,它是一个工具,能定期采集系统和应用的指标数据,把这些时间序列数据保存下来,并提供查询能力的一个工具
比如我有一台服务器,我想知道这台服务器的 CPU 使用率、内容使用率、磁盘剩余空间...这些都属于 Prometheus 典型的监控数据,而这些数据别统一称为 Metrics(指标)
比如 www.raymq.com ,这是我的博客。有一天我突然发现,我登录我的博客特别慢,我想知道是什么问题导致的,是 CPU、内存、数据库 还是 请求量太大了。我需要上服务器使用 top、free、df...看看到底是什么问题,但是这些命令有局限性,就是我只能看到当前状态下,CPU、内存 之类的数据是怎么样的,我不知道 5 分钟前、10分钟前内存使用了多少、请求量有多少
这时候,Prometheus 就派上用场了,它能不断采集 CPU 的使用率,比如
10:00 CPU = 25%
10:01 CPU = 27%
10:02 CPU = 31%
10:03 CPU = 92%
于是,你就能得到一个 x-y 图形,随着时间变化,CPU使用率也在变化,这就是时间序列(Time Series),我们也可以称呼其为时序数据(以下都用此称呼描述)
CPU
100% |                    *
 80% |
 60% |
 40% |        *
 20% | *  *
     +-------------------------
       10:00 10:01 10:02 10:03
2、时序数据(时间序列)
从上面图我们可以看到,随着时间变化,CPU使用率也在变化。也就是说,时序数据最重要的就是 时间 + 数值
时间                  CPU
10:00:00              20
10:00:15              24
10:00:30              35
10:00:45              80
因此,一个 指标 本质上会反映成 时间 -> 数值 这么个形式
3、什么是 Metrics
我认为 Metrics 不需要额外去解释,因为这是一个抽象的概念,如果硬要解释,我认为应该是 对系统的某个状态使用数字进行描述,我们以 redis 指标举个例子,我想你就能明白了
# HELP redis_connected_clients 当前连接的客户端数量
# TYPE redis_connected_clients gauge
redis_connected_clients{instance="redis-prod-01"} 2
这是一条标准的 Prometheus 文本格式数据,我们一起来看一下都是什么
Metric Name(指标名称)
redisconnectedclients 就是一个指标名称,它表达的意思是 我现在测量的东西是什么,从名称上我们可以直观的判断,这个指标想表达的意思
- redis、connected、clients
- redis、已经连接的、客户端数量
我认为,这是官方设计的一种小巧思吧。指标名称使用统一的应用前缀、基础单位,并通过 _seconds、_bytes、_total 等后缀去体现单位和语义
Label(指标标签)
{instance="redis-prod-01"} 就是一个指标标签,用于区分这个指标不同维度的数据特征
需要注意的是 {} 也是一个标签整体,它表示为一个集合,在这个 {} 里的都是筛选条件。而 {} 的内容,就是一个具体的标签匹配对,换句话说是一个键值对。比如这里的 instance 是 键、redis-prod-01 是 值。而 值 我们一般使用 "" 或者 '' 去进行引用,目的是防止语法解析报错
所以这个标签表示的意思就是,取,与 实例为 redis-prod-01 匹配的 redis 值
Label 同样可以支持多个 键值对 进行展示,比如
# HELP redis_up Redis 实例是否存活(1=存活,0=不可达)
# TYPE redis_up gauge
redis_up{instance="redis-prod-01", address="10.0.1.10:6379"} 1
我们一般称呼 Label 为 维度
Value (指标数值)
- 2 指标数值,表示的是当前这个指标的数值是多少
因此,这个指标整体的意思就可以表示为 实例为 redis-prod-01 的 redis 已经连接的客户端数量是 2
TimeStamp(时间戳)
上面我们了解了什么是 Prometheus 文本格式的数据,将 Metrics Name + Label + Value 进行组合成一条数据,而我们常见的还会有 TimeStamp 字段,比如
redis_connected_clients{instance="redis-prod-01"} 2 1788872400
其中的 1788872400 属于 UNIX 时间戳,单位是 毫秒,换算成 UTC(世界标准时间)也就是 2026年9月8日13:00:00,再加上 8h 就变成了 UTC + 8 也就是北京时间
4、四种 Metrics 类型
在上文提到的 redis 指标中有一个 # TYPE redis_up gauge,不知道大家是否有注意到这里的 gauge。这就是一种 Metrics 类型,Prometheus 提供了 4 种指标类型,分别是 Counter、Gauge、Histogram、Summary
Counter
Counter 表示 只能增加 或者 在进程重启等情况下归零的,累计值,一个单调递增、只能增加或者重置为 0 的累计指标,比如
# HELP redis_commands_processed_total 累计处理的命令总数
# TYPE redis_commands_processed_total counter
redis_commands_processed_total{instance="redis-prod-01"} 78234156
但是,我希望大家能观察到这么个现象 78234156 这个数字,有意义吗?我想是没有的,因为它只能体现这个指标的总数非常大,但你告诉我除了大还有什么吗?所以,这时候就需要使用 PromQL 了,我们后面再聊
Gauge
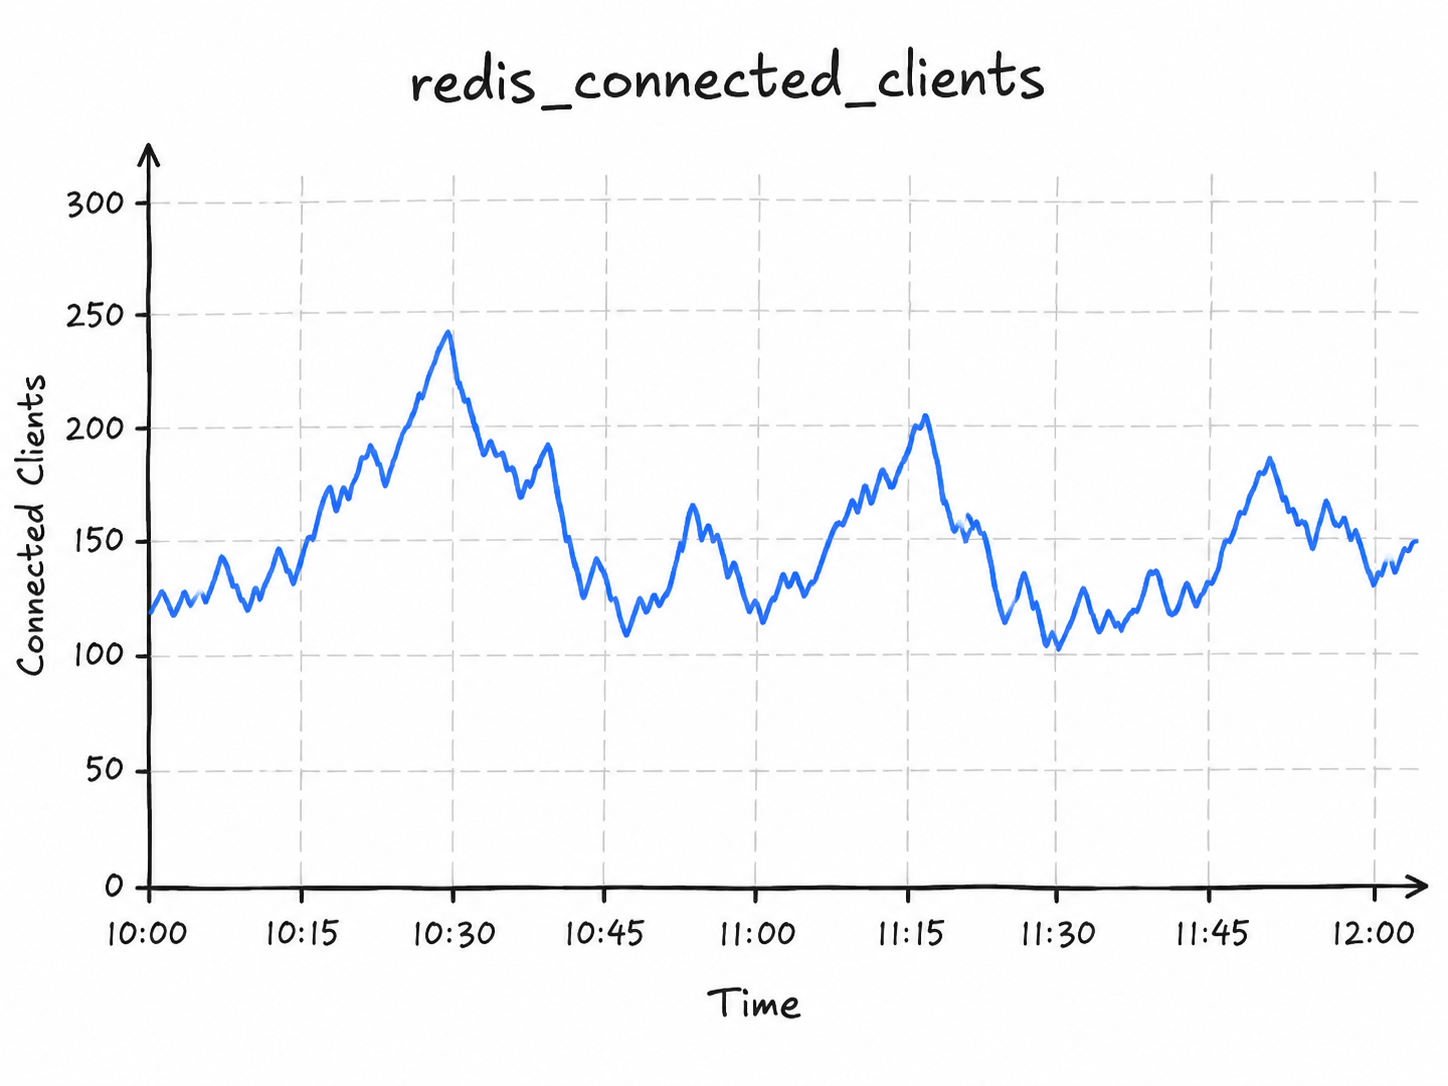
Gauge 表示 当前状态,一个可以任意上升或下降的单一数值。比如上文提到的 redis_connected_clients,它就是 Gauge 类型的指标,它所呈现出的数值是一个随着时间可以上下波动的数据,如同所示
Histogram
Histogram 用于观察一批数据的分布。这是一个比较抽象的概念,最典型且常见的例子是 HTTP 请求响应时间。
比如当前有 5 个请求,0.1s、0.2s、0.3s、0.8s、2.0s,我不只想知道 平均响应时间,我还想知道 90% 的请求能否在 xx 秒内完成?95% 呢?99% 呢?
而这就是 P90、P95、P99。Histogram 解决的就是这类型问题的指标
Bucket
这里我们额外扩展一个知识,Classic Histogram 也称呼为 经典 Histogram,它会把数据放到不同 Bucket 中。
比如当前有如下纬度 <= 0.1s、<= 0.5s、<= 1s、<= 2s、<= +Inf;当前有一次请求耗时为 0.3s,那么这次耗时比 0.1s 大、0.5s 小。也就是 <= 0.5s、<= 1s、<= 2s、<= +Inf 数值会增加一次
我们多看点例子,总共 100 个请求
# 10 个 <= 0.1s
http_request_duration_seconds_bucket{le="0.1"}  10

# 80 个 <= 0.5s
http_request_duration_seconds_bucket{le="0.5"}  80

# 95 个 <= 1s
http_request_duration_seconds_bucket{le="1"}    95

# 99 个 <= 2s
http_request_duration_seconds_bucket{le="2"}    99

# 100 个 <= +Inf
http_request_duration_seconds_bucket{le="+Inf"} 100
Classic Histogram 还会产生类似于 xxxbucket、xxxsum、xxx_count 这种指标名称
官方当前提供了 Classic Histogram 和 Native Histogram;Native Histogram 使用复合样本保存 count、sum 和动态 buckets,而 Classic Histogram 会展开成多条普通时间序列,这里简单了解一下即可
Summary
Summary 与 Histogram 类似,带有统计的含义,并且能统计 响应时间、请求大小,以及还可以进行计算 Quantile(分位数),比如
quantile="0.5"
quantile="0.9"
quantile="0.99"
但 Summary 与 Histogram 的区别在于
- Histogram -> Prometheus 根据 Bucket 数据计算分位数
- Summary -> 客户端程序提前计算分位数
换句话说就是 Summary 的 Quantile 不方便跨实例聚合。假设我有 3 台机器 A、B、C,我想知道这三台机器的 P95 就不能直接使用 avg(AP95, BP95, C_P95) 得出整个系统的真正 P95
聚合
这里的聚合的意思就是把多个数据点“合并”成一个更有意义的数据点,涉及到 PromQL 函数,比如 sum()、avg()、max()、min(),举个例子就是
全班 50 个学生的数学成绩 {85, 92, 78, 90, ...},通过聚合操作得到

求 平均分( avg )→ 86.5 分
求 总分( sum )→ 4325 分
求 最高分( max )→ 100 分
求 最低分( min )→ 52 分
5、Prometheus 数据模型
Prometheus 数据模型,指的是 Prometheus 是如何组织、区分和存储这些 Metrics 数据
在前面我们知道了一条数据大概长什么样,再来回顾一下吧
redis_connected_clients{instance="redis-prod-01"} 2 1788872400
而Prometheus 并不是单纯通过 Metric Name 来区分一条时序数据,而是通过 Metric Name + Labels 来确定一条 Time Series,我们再来回顾一下什么是 Time Series 时序数据
Time Series
比如
redis_connected_clients{instance="redis-prod-01"} 2 1788872400
redis_connected_clients{instance="redis-prod-02"} 5 1788872600
虽然它们的 Metric Name 都是 redisconnectedclients,但是由于它们的 Label 也就是纬度不同,所以在 Prometheus 看来,这是两条完全不同的 Time Series 时序数据
并且我们通过大量的 时序数据,得到了一个范围,借鉴上图
CPU
100% |                    *
 80% |
 60% |
 40% |        *
 20% | *  *
     +-------------------------
       10:00 10:01 10:02 10:03

10:00 -> 25%
10:01 -> 27%
10:02 -> 31%
10:03 -> 92%
我们可以将这个范围里每一条 时间 -> 数值称为 Sample 样本
由此,我们就能串联起来以上的知识
redis_connected_clients{instance="redis-prod-01"} 2 1788872400
redis_connected_clients{instance="redis-prod-01"} 3 1788874400
redis_connected_clients{instance="redis-prod-01"} 5 1788876400
redis_connected_clients{instance="redis-prod-01"} 7 1788878400
redis_connected_clients{instance="redis-prod-01"} 4 1788880400
一条 Time Series 实际上是由很多 Sample 按照时间不断组成的
当 Label 发生了变化,也就是 redis-prod-01 变成了 redis-prod-11,那么这一条数据,就变成了一条 全新的时序数据,也就是维度只要变化,那就是新的数据
Cardinality
既然不同的 Label 组合会产生不同的 Time Series,那么这里就会自然产生一个问题,当我的维度足够多,用户足够多,仅一条指标,就会产生非常庞大的时序数据条数
- 比如有 100w 用户,使用 httprequest{userid="xxx"} 展示,就会有 100w 条数据
- 如果维度再加上 2 种 method、10个 path、5个 status 那就会有 100w x 2 x 10 x 5 条数据
理论上,这个数据会变的非常庞大,所以我们通常称这个现象为 Cardinality ,也就是基数,因此,在 Prometheus 中设计 Label 的时候,一般不会把一些变化范围非常大的值直接作为 Label,以此避免出现 高基数现象
- userid、email、requestid、trace_id、订单号、UUID 等...
总结
这一篇也算是花费了不少笔墨去讲解,也算是 Prometheus 中非常重要且非常基础的一章,尽管我的讲解多多少少还存在一些让人捉摸不透的地方
但记住我常说的话,有印象就足够了
愿诸君顺遂